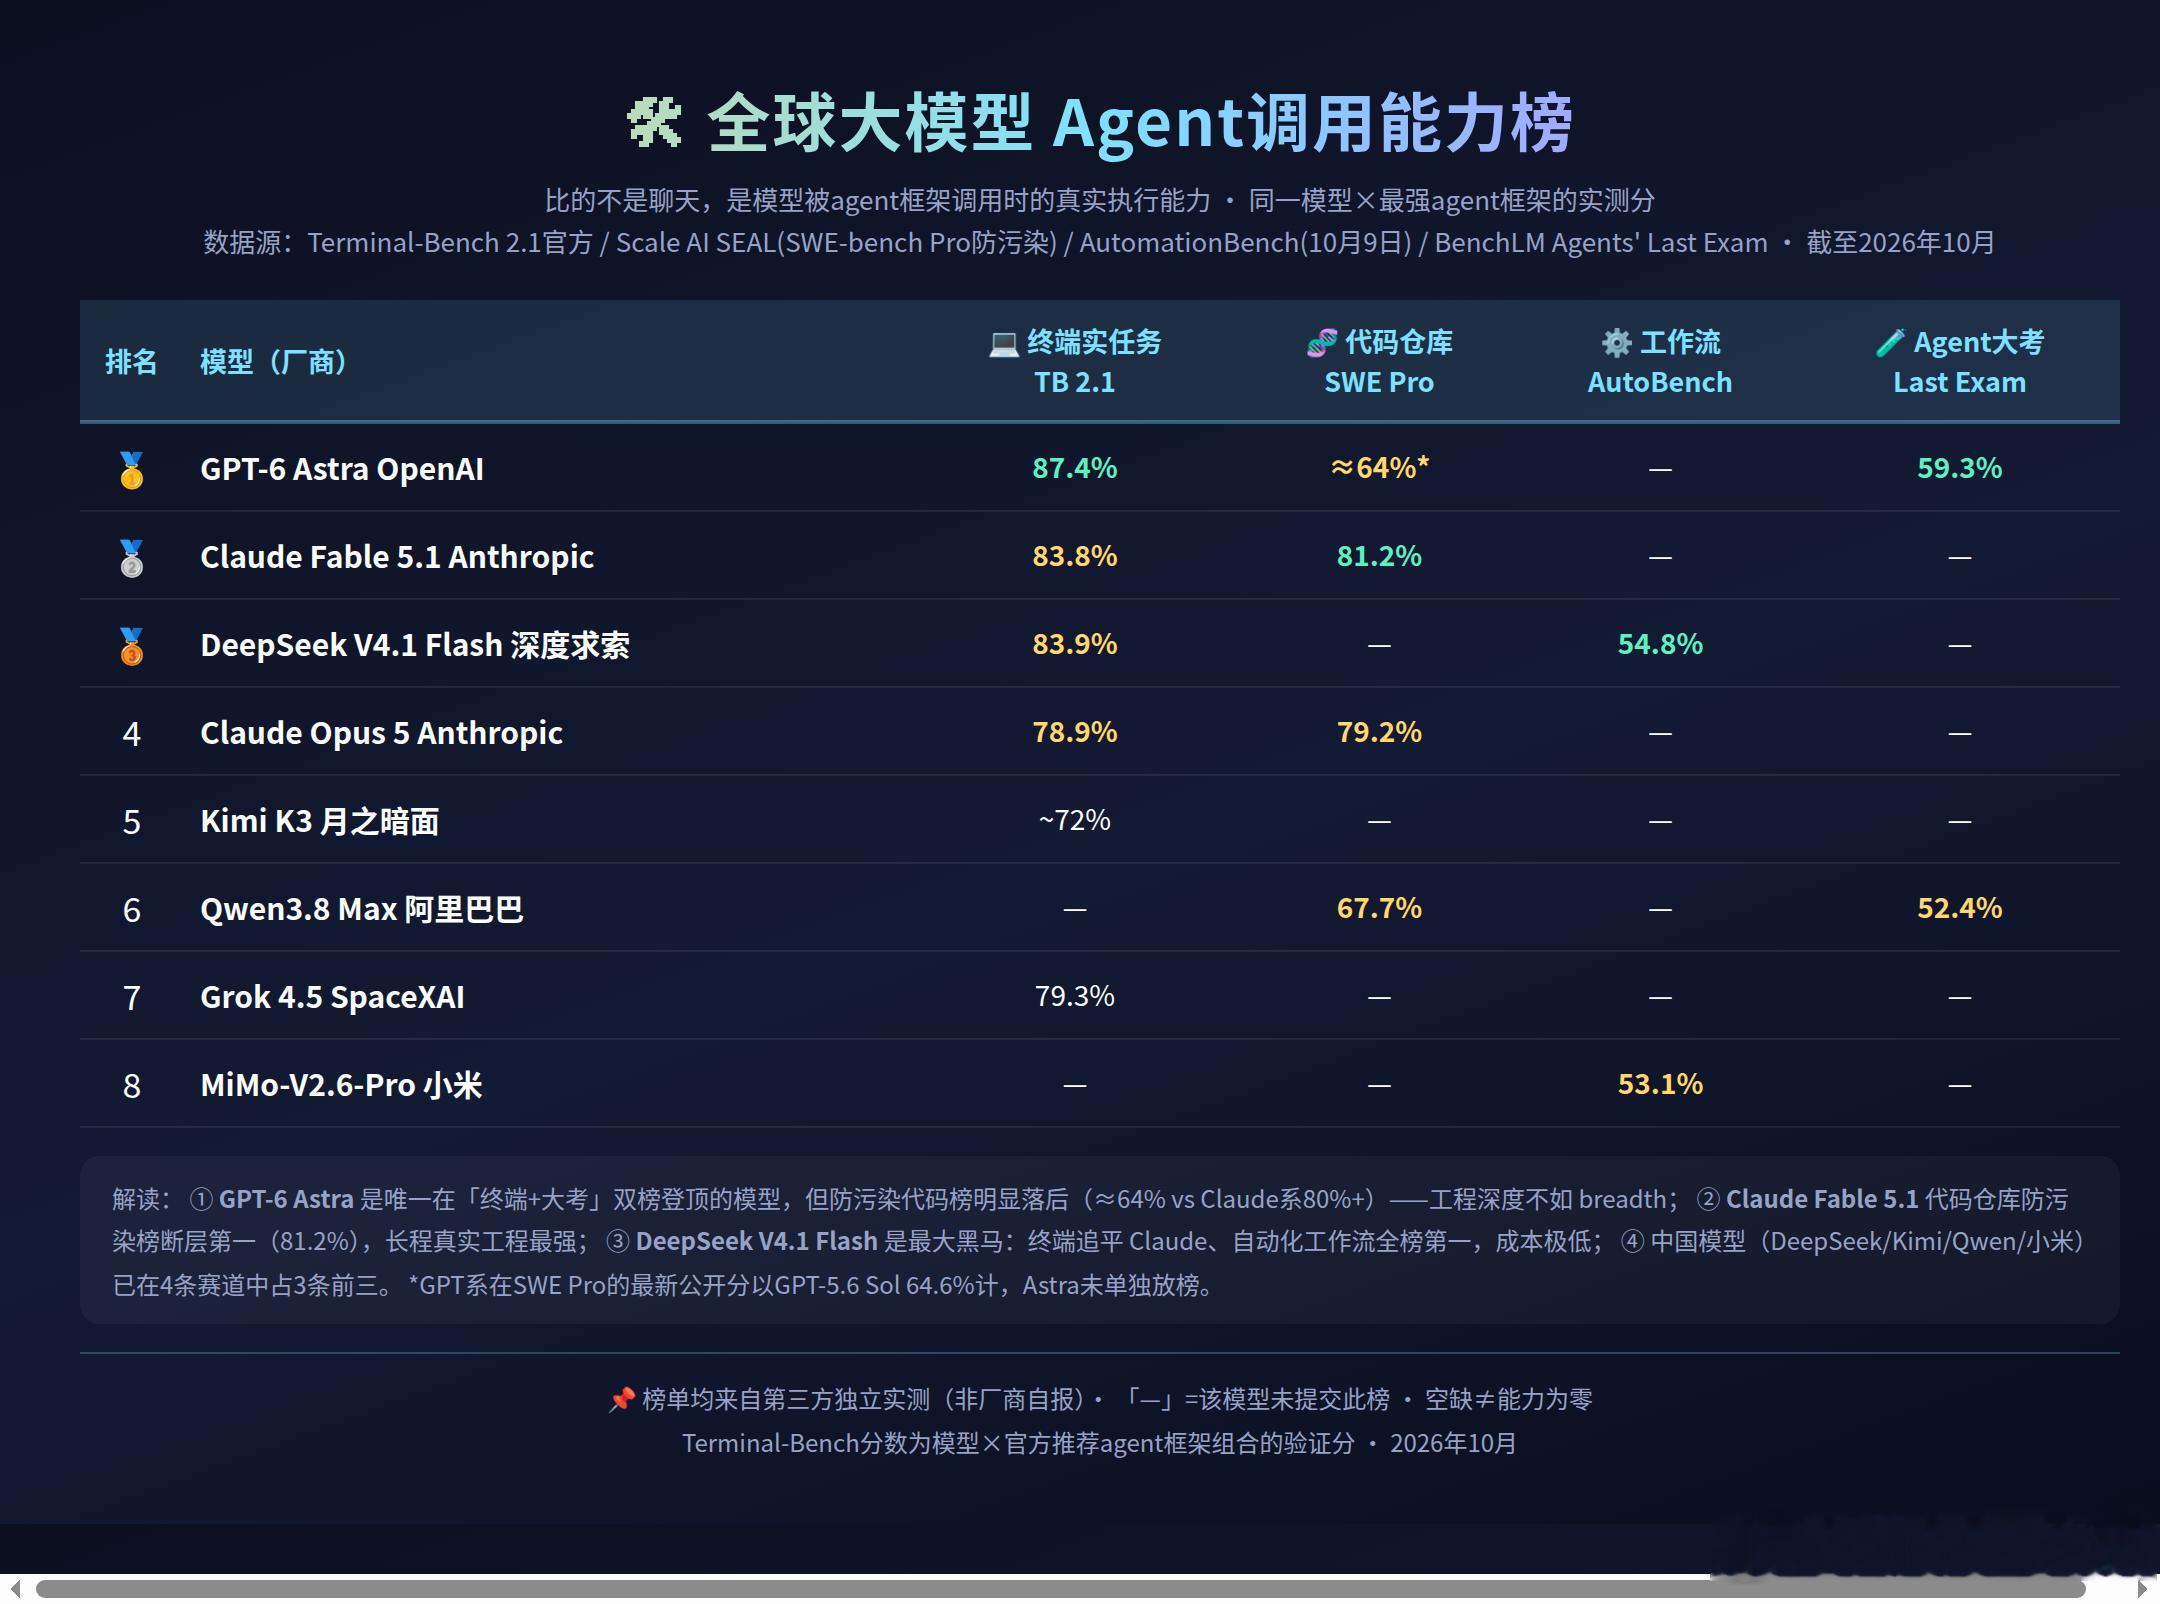
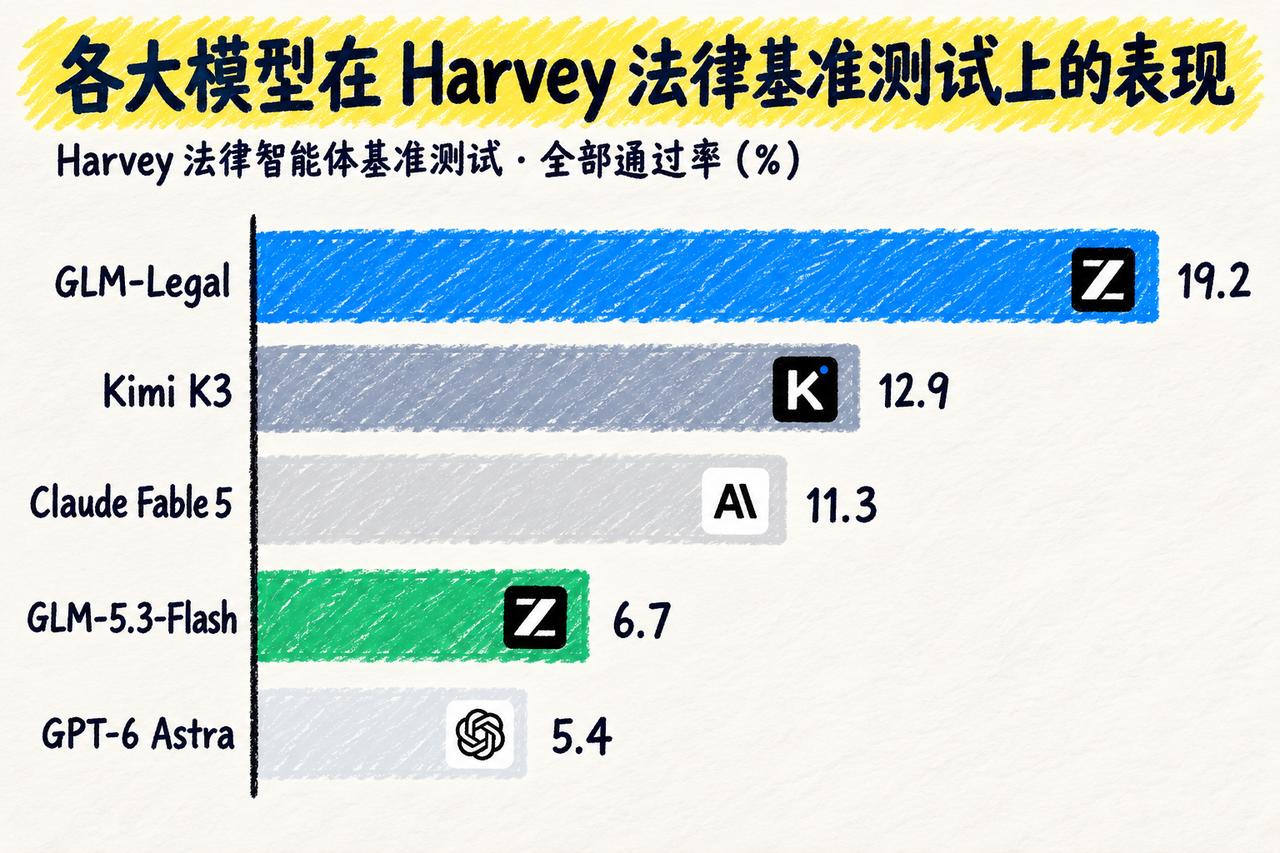
🛠 AI模型「干活能力」大排名来了!天天听跑分榜看腻了?这张榜不看聊天不看作文,专门测大模型被AI Agent调用时的真实干活能力——编译代码、修bug、跨系统执行任务,全是硬仗。——————GPT-6 Astra(OpenAI):终端任务87.4%登顶、Agent综合大考59.3%第一,双料冠军。但一到防作弊的真实代码仓库榜就掉队,只有64%左右——广度之王,深度存疑。Claude Fable 5.1(Anthropic):真实代码仓库修复81.2%断层第一,比第二名还高,工程活天花板。这也是为啥程序员都爱用Claude写代码。DeepSeek V4.1 Flash(深度求索):本次最大黑马!终端任务83.9%直接追平Claude,自动化工作流榜全榜第一,价格还便宜。中国模型这次是真杀出来了。——————还有一个容易被忽略的点:中国模型在这4条硬核赛道里,DeepSeek、Qwen、Kimi、小米MiMo占了3条的前三。工作流榜前三甚至全是国产(DeepSeek、Atria、小米MiMo)。——————📌 一句话总结:OpenAI赢在广度,Anthropic赢在深度,国产模型赢在性价比和执行力。💬 今日话题:如果让你选一个AI帮你干活(写代码/跑任务),你选谁?是选最贵的Claude/GPT,还是便宜大碗的DeepSeek/Kimi?评论区聊聊👇