国产 AI 芯片这波真的杀疯了!被美国多次制裁的壁仞科技,直接掏出了对标英伟达满血 H200 的新一代旗舰 BR20X。 BR20X不仅成功点亮完成启动测试,还正式进入流片后验证阶段。
别小看 “成功点亮” 这四个字,这说明了,晶圆制造没有致命硬件缺陷,从电路设计、封装集成到晶圆制造的全核心环节全部跑通。
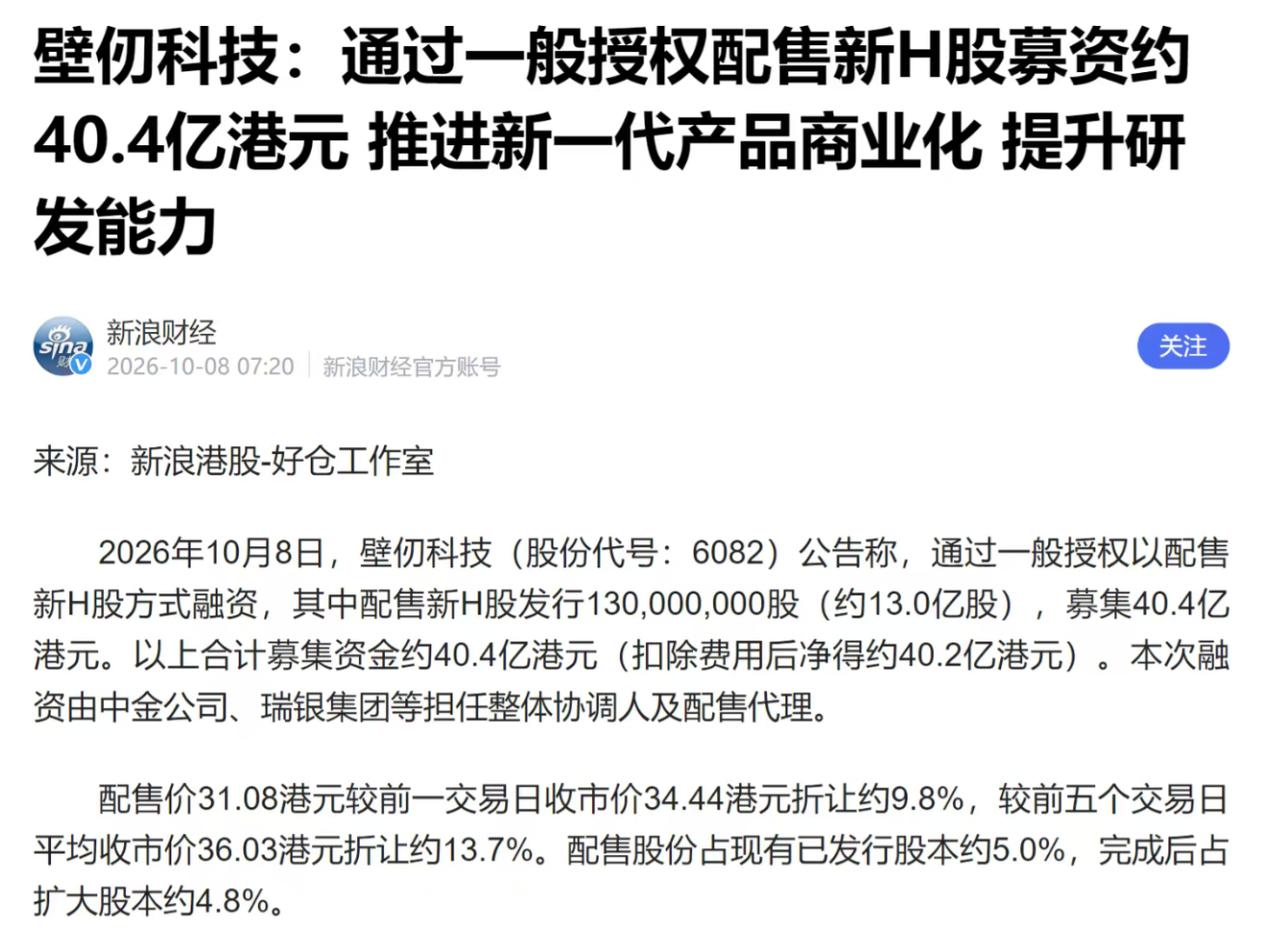
就在10月8日,壁仞科技官方发布配售公告,实锤了这个让整个半导体圈震动的消息。很多人可能对“成功点亮”没什么概念,觉得不就是芯片通上电亮个灯吗?
根本不是一回事。
芯片从图纸上的几十亿晶体管,变成手里实实在在的硅片,要经历架构设计、物理实现、流片、封装、测试几十个精密环节,任何一个环节出哪怕微米级的差错,这颗芯片就直接报废。
“成功点亮”意味着首批流片回来的晶圆,经过封装之后第一次通电,就顺利跑通了所有基础功能。
这背后代表的是电路设计没有致命bug,封装集成没有出现故障,最关键的晶圆制造环节,也没有出现良品率灾难。一句话,从0到1的全核心流程,彻底跑通了。
要知道,就在三年前,几乎没人敢想壁仞能走到这一步。
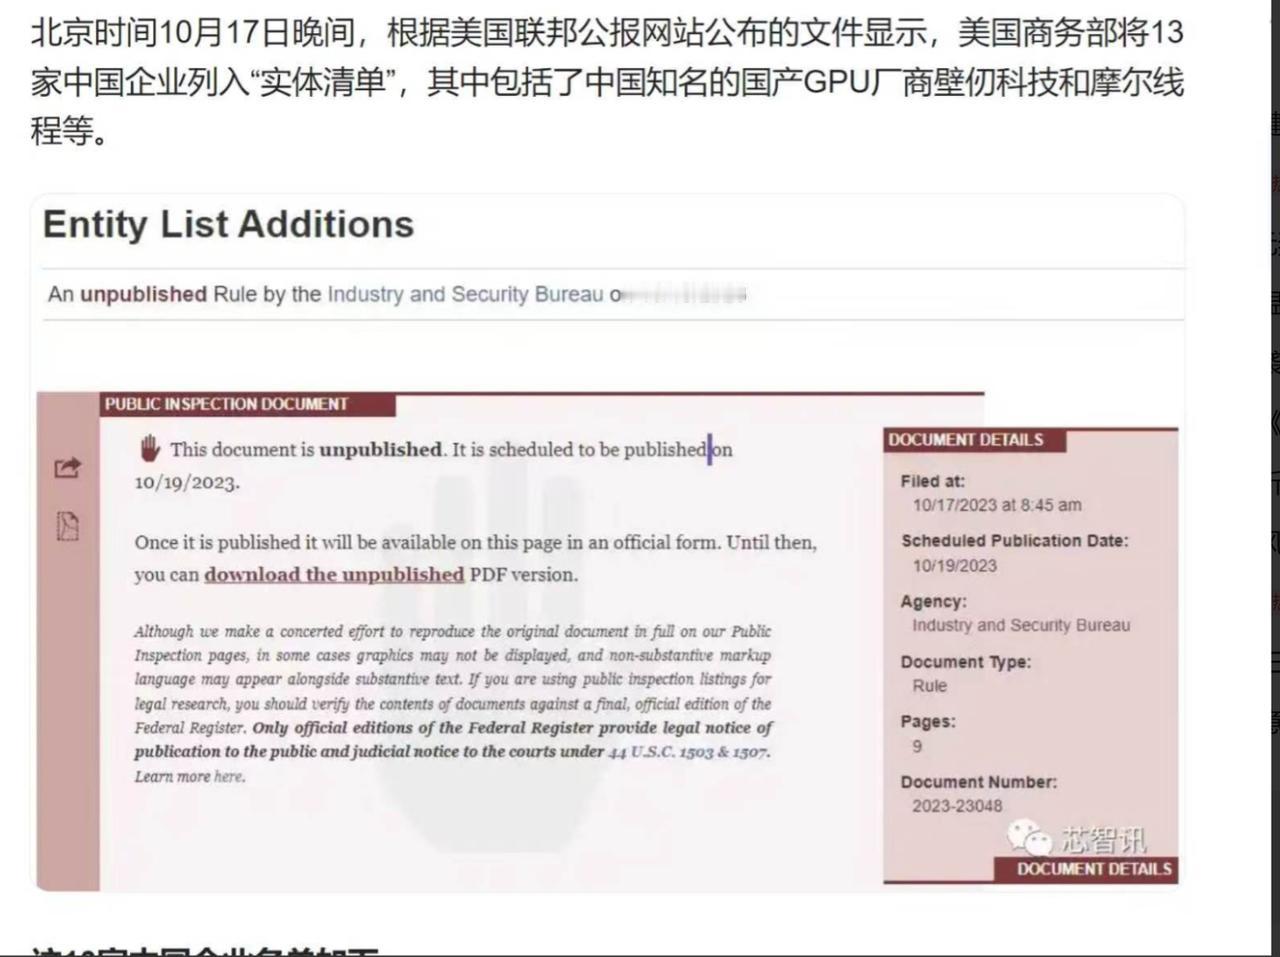
2023年10月17日,美国商务部下属的工业安全局直接把壁仞科技列入实体清单。当时的壁仞,第一代产品BR100原本采用台积电7纳米工艺,正准备借着大模型爆发的东风大展拳脚。
制裁一来,台积电不能给它代工了,所有含美国技术的设备、材料、设计软件,通通都不能用了。当时很多行业评论都在说,国产高端GPU的路,又被美国人堵死了。
毕竟高端AI训练芯片这种东西,在那之前全球只有英伟达一家能玩明白,AMD都只能跟在后面吃灰。一个成立没几年的中国公司,被直接断了供应链,还怎么搞高端芯片?
但壁仞用实际行动打了所有人的脸。
被制裁之后,壁仞没有躺平,反而一头扎进了国产供应链的深度适配当中。从制造工艺到生产设备,从原材料到封装测试,全部重新梳理,全部走国产替代路线。
不到三年时间,BR20X就成功点亮了。而且这不是什么阉割版、降频版的过渡产品,是直接对标英伟达满血版H200的旗舰级产品。
根据多家权威媒体援引知情人士的消息,这款芯片完全基于国产工艺打造,整体计算性能与能效指标实现大幅提升,甚至超过了英伟达H200。
可能有人对H200的分量没概念,这是目前英伟达在AI训练领域的天花板级产品,也是全球智算中心争抢的硬通货。它搭载141GB HBM3e显存,显存带宽达到4.8TB/s,是上一代H100的1.4倍,别说采购了,很多厂商排队半年都拿不到货。
而壁仞BR20X,直接把目标对准了这个行业天花板。
从壁仞官方披露的信息来看,BR20X在算力密度、内存容量和带宽、互连带宽上都做了全面升级,原生支持FP8、FP4等低精度计算格式,刚好踩中了当下大模型训练和推理的核心需求。
更狠的是壁仞的系统级能力。BR20X搭载了自研的Blink2.0互连协议,配合对应的超节点方案,最大可以支持千卡规模的集群扩展,还兼容主流的SUE协议,适配多种南向交换机,甚至支持在网计算功能,专门针对MOE混合专家模型这种行业大趋势做了深度优化。
要知道,AI芯片从来不是单打独斗,集群扩展能力才是真正的门槛。能不能做成千上万张卡协同工作的大集群,直接决定了这款芯片能不能用在国家级超算中心和头部互联网厂商的算力基地里。
壁仞这一步,直接把单卡性能和集群能力都拉满了。
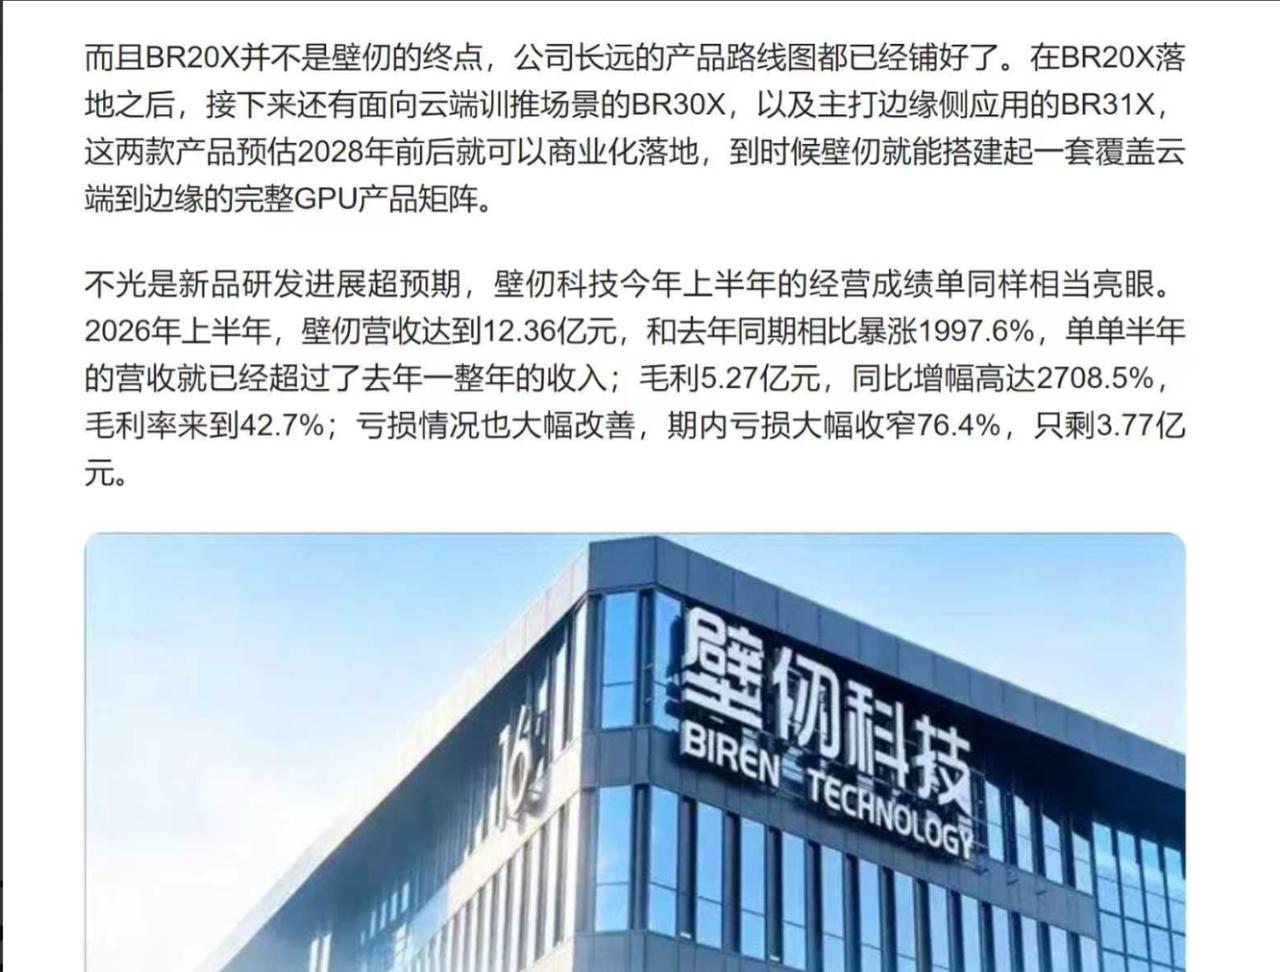
伴随着BR20X点亮的消息,壁仞同时宣布完成了40.40亿港元的定向配售,引入的都是高质量的国际长期投资者。
这笔钱来得恰到好处。现在全球AI算力需求爆炸式增长,晶圆产能持续紧张,关键原材料价格一路上涨,提前锁定产能、备好供应链库存,才能保证产品按时按量量产交付。
壁仞这波相当于技术突破和资金储备同时到位,直接把量产的油门踩死了。
按照目前公开的进度,BR20X接下来会完成全部流片后验证工作,预计在未来几个季度就正式启动客户送样,2027年就能实现规模化部署。
现在壁仞已经在和头部互联网企业、大模型厂商、国家级算力平台这些核心客户接洽落地部署的事了。
从被卡脖子的BR100,到完全自主可控的BR20X,壁仞用了不到三年。从只能对标H100,到直接对标H200,国产AI芯片的追赶速度,超出了所有人的预期。
美国想用一纸制裁把中国AI芯片产业掐死在摇篮里,结果反而逼出了一个全链条自主的产业体系。打压越狠,反弹越强,这大概就是他们最不想看到的结果。
国产AI芯片的突围战,才刚刚打响最精彩的部分。
评论列表