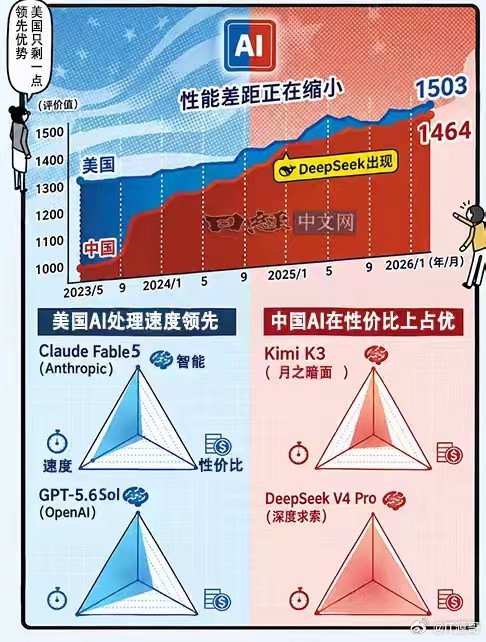
DeepSeek正在全力训练2万亿参数(2T)的大模型,远期目标更是直接锁定在令人咋舌的8万亿(8T)。
而最让硅谷和华尔街睡不着觉的细节是——这套庞大工程的底层,正在大规模切换为国产华为芯片,相关训练卡最早将于今年第四季度批量到货。
从现役1.6T的V4-Pro直接跃迁到2T乃至8T,这不仅是一场数字上的狂飙,更是国产算力生态的一次渡劫。
过往大家对国产芯片的印象,多半还停留在能跑跑推理、做做微调的辅助角色。而这一次,DeepSeek直接把华为芯片推上了终极战场——去训练下一代最前沿的超大旗舰模型。这是国产芯片第一次被推到“能不能炼出世界顶级AI”的生死考场上。
仔细想想,这背后的逻辑充满反讽。过去几年,老美为了卡住中国的AI咽喉,玩尽了精准切割的戏码:先禁高端A100和H100,再限制H800和A800,最后干脆送来性能大幅缩水的特供阉割版。按他们的算盘,只要断了高带宽显卡,中国的算法大厂就只能在算力泥潭里打转。
可他们算漏了梁文锋和DeepSeek这群性价比狂魔。
DeepSeek从诞生第一天起,玩的就是在算力绳索上跳芭蕾的绝活。当硅谷巨头靠暴力堆砌数万张顶级英伟达显卡搞大力出奇迹时,DeepSeek却凭借极其刁钻的架构优化和工程调度,硬是用极低的成本把性能拉到了第一梯队。现在,当这套极致的算法优化遇到不得不用的国产芯片,最硬核的化学反应发生了。
当华为的硬件算力与DeepSeek的极致工程架构交汇,这已经不是简简单单的国产替代,而是一场对AI产业链秩序的重构。过去,没有英伟达的CUDA生态,几乎所有大模型厂商都寸步难行;但如果DeepSeek真能用华为训练卡拉通2T甚至8T的训练全流程,就意味着“硬件不足算法凑、生态不够自己构”的道路彻底被验证通了。
出口管制逼出来的路线图,正在变成真金白银的交付时间表。当老美还在犹豫要不要继续打磨下一款特供芯片时,中国的AI领头羊已经开始收拾行李,准备彻底搬离英伟达的算力客栈了。
大模型的算力冰河期里,被关在门外的人没有冻死,反而学会了自己搭建核聚变反应堆。这场发生在算法与芯片最深处的突围战,好戏才刚刚敲响锣鼓。

评论列表