18张图讲透MoE混合专家架构
DeepSeek-V3、Mixtral、Grok-1、DBRX 背后都是同一种架构:MoE(Mixture-of-Experts,混合专家)。读完 Cameron Wolfe 的 MoE 长文,整理成 17 张图 + 中文解读。
【MoE 是什么】
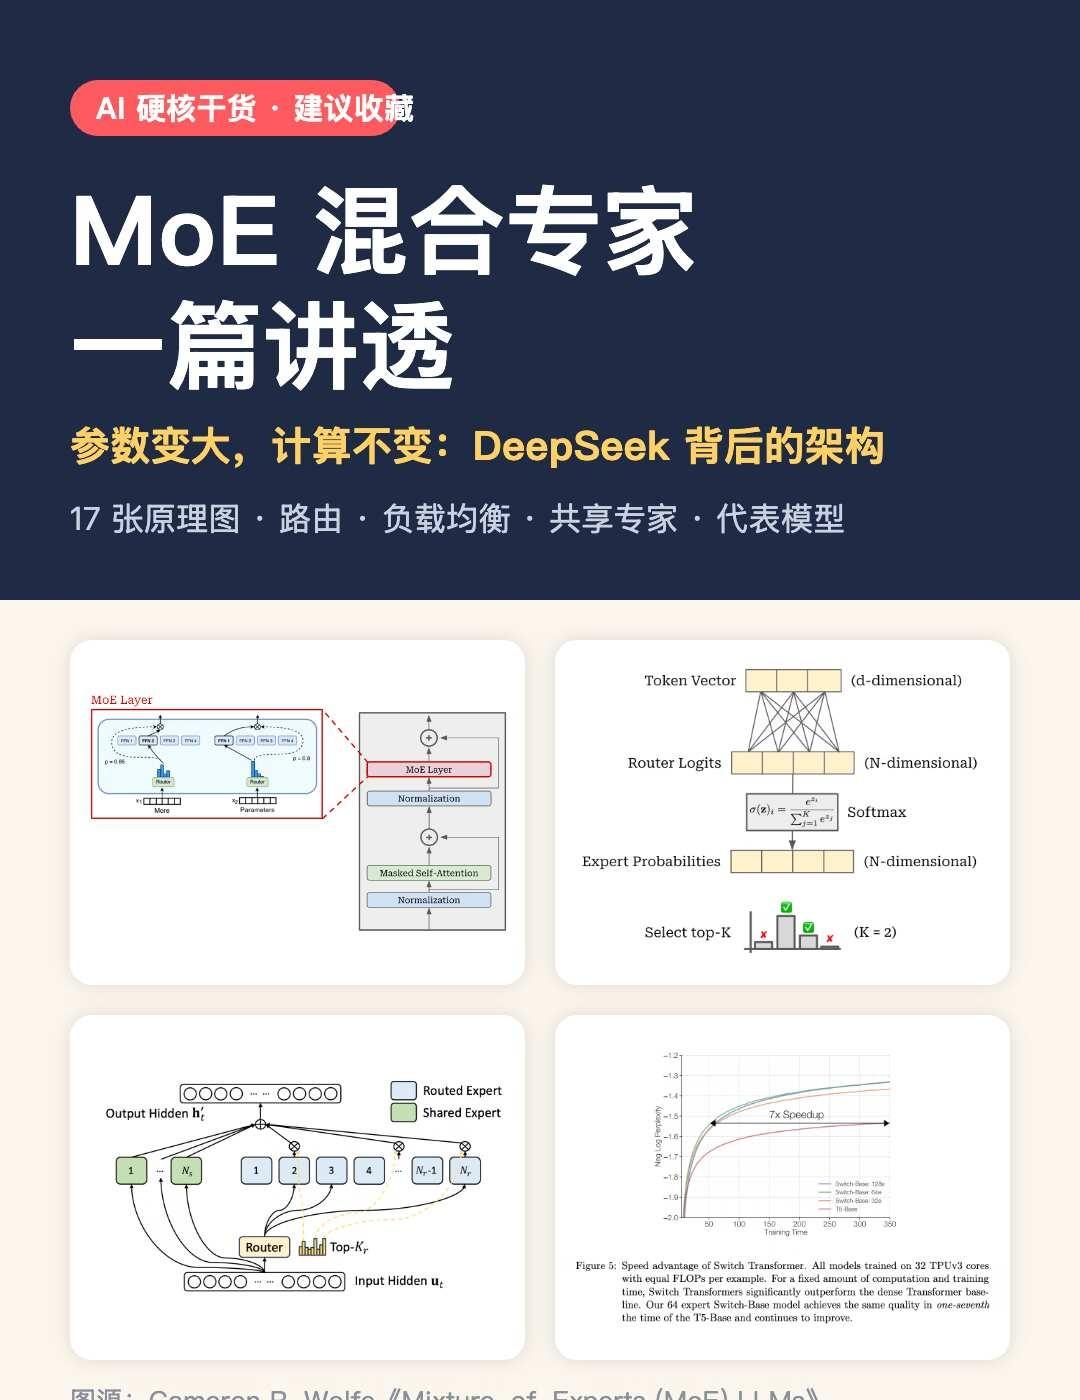
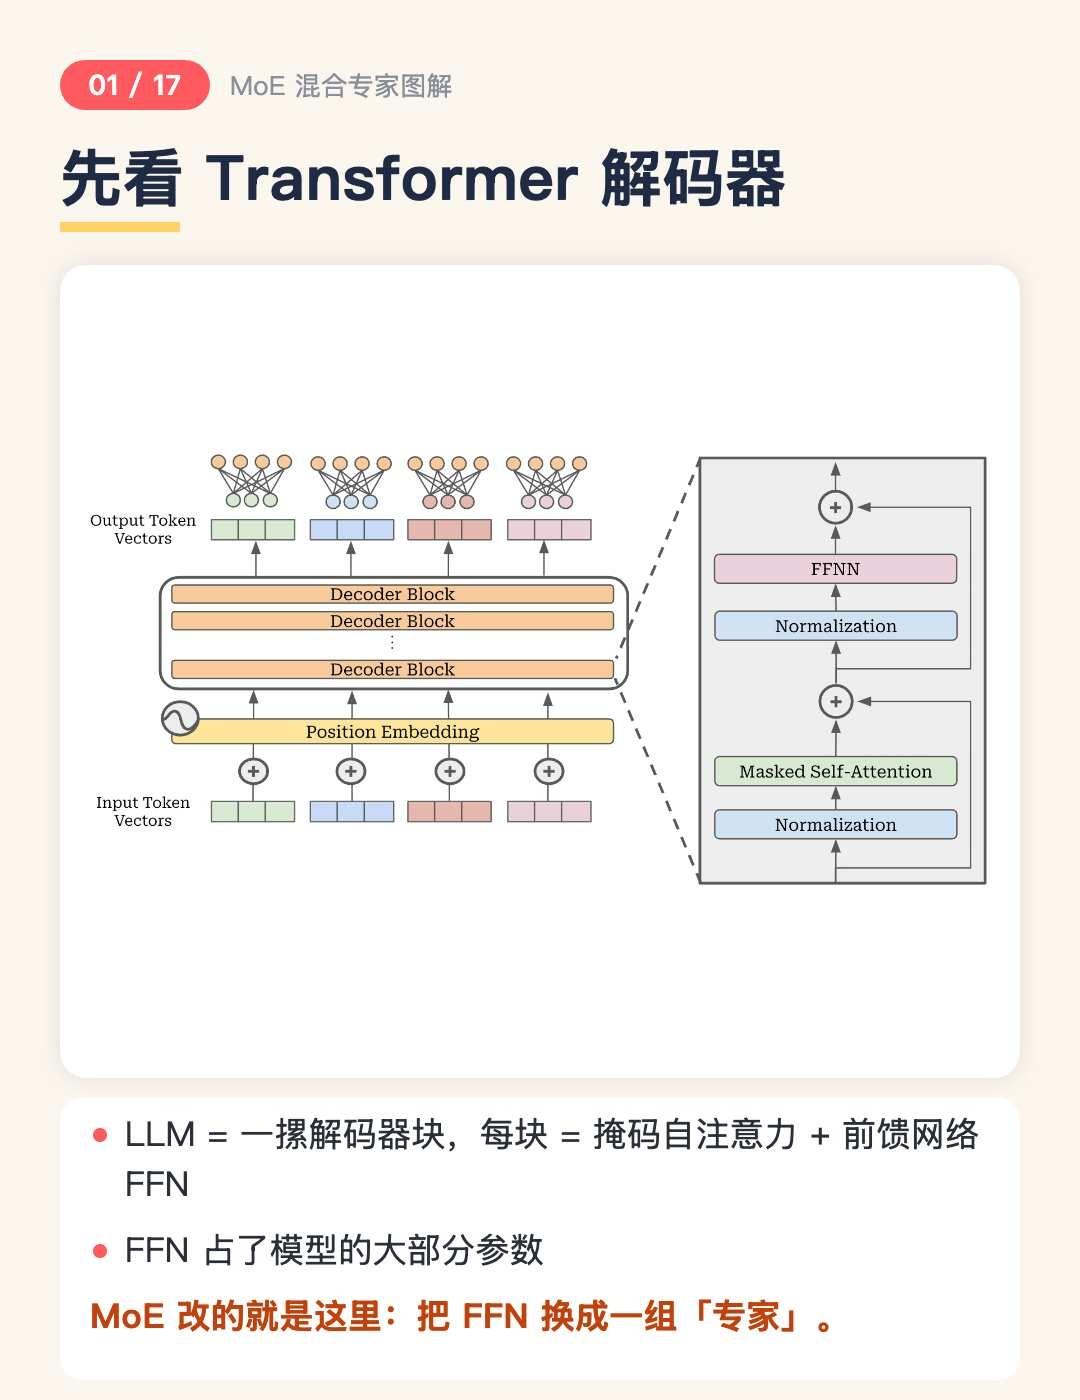
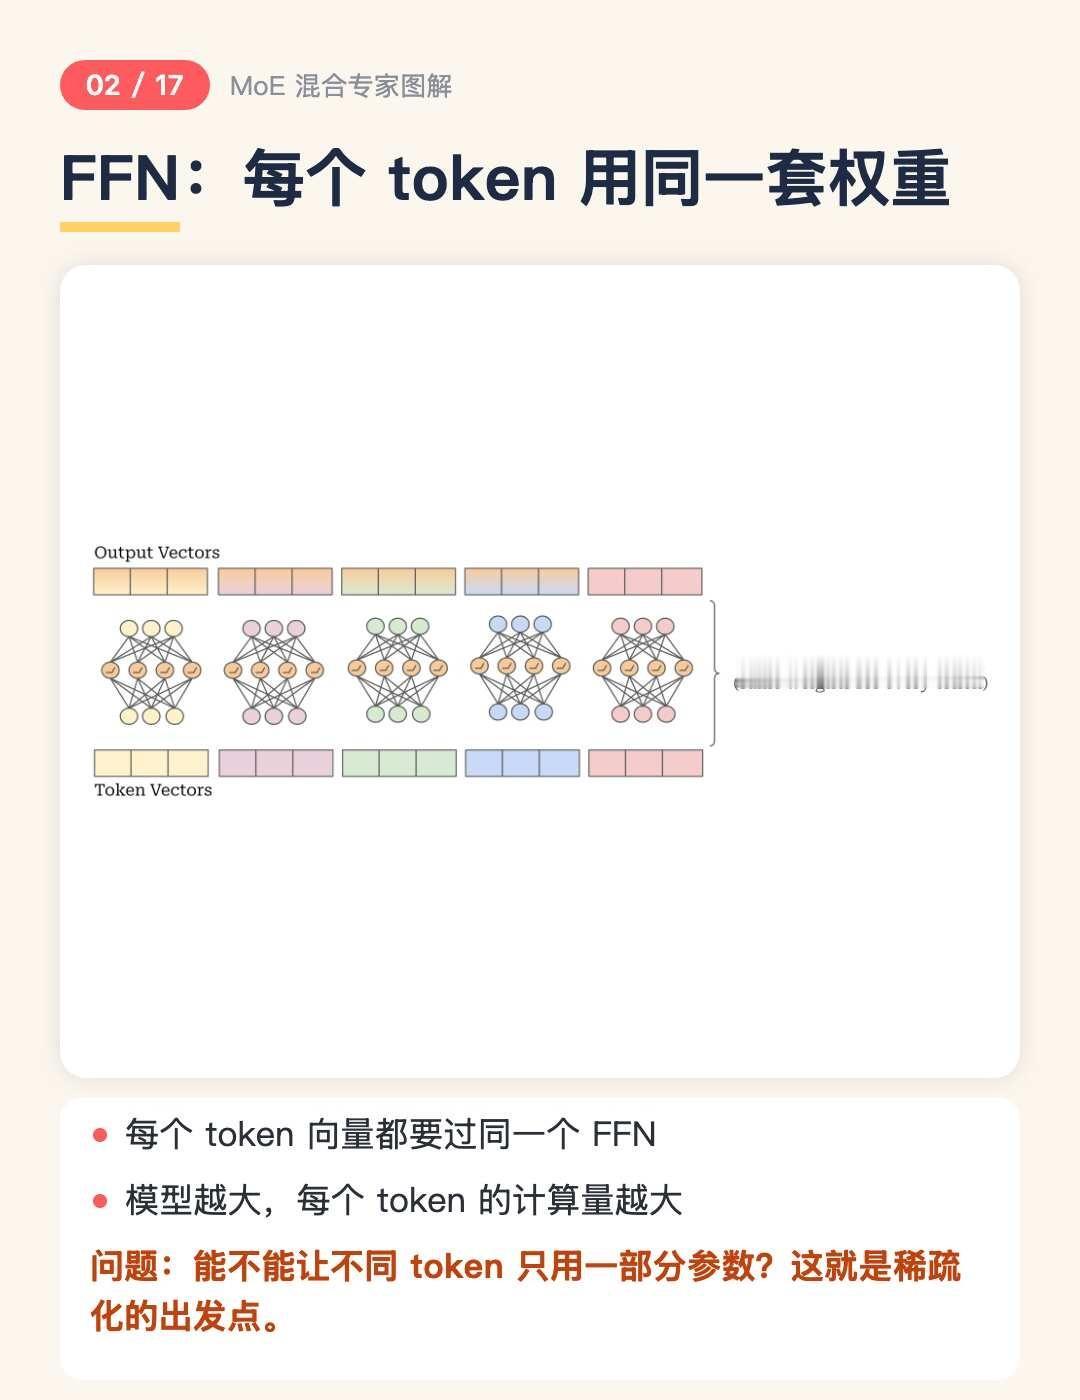
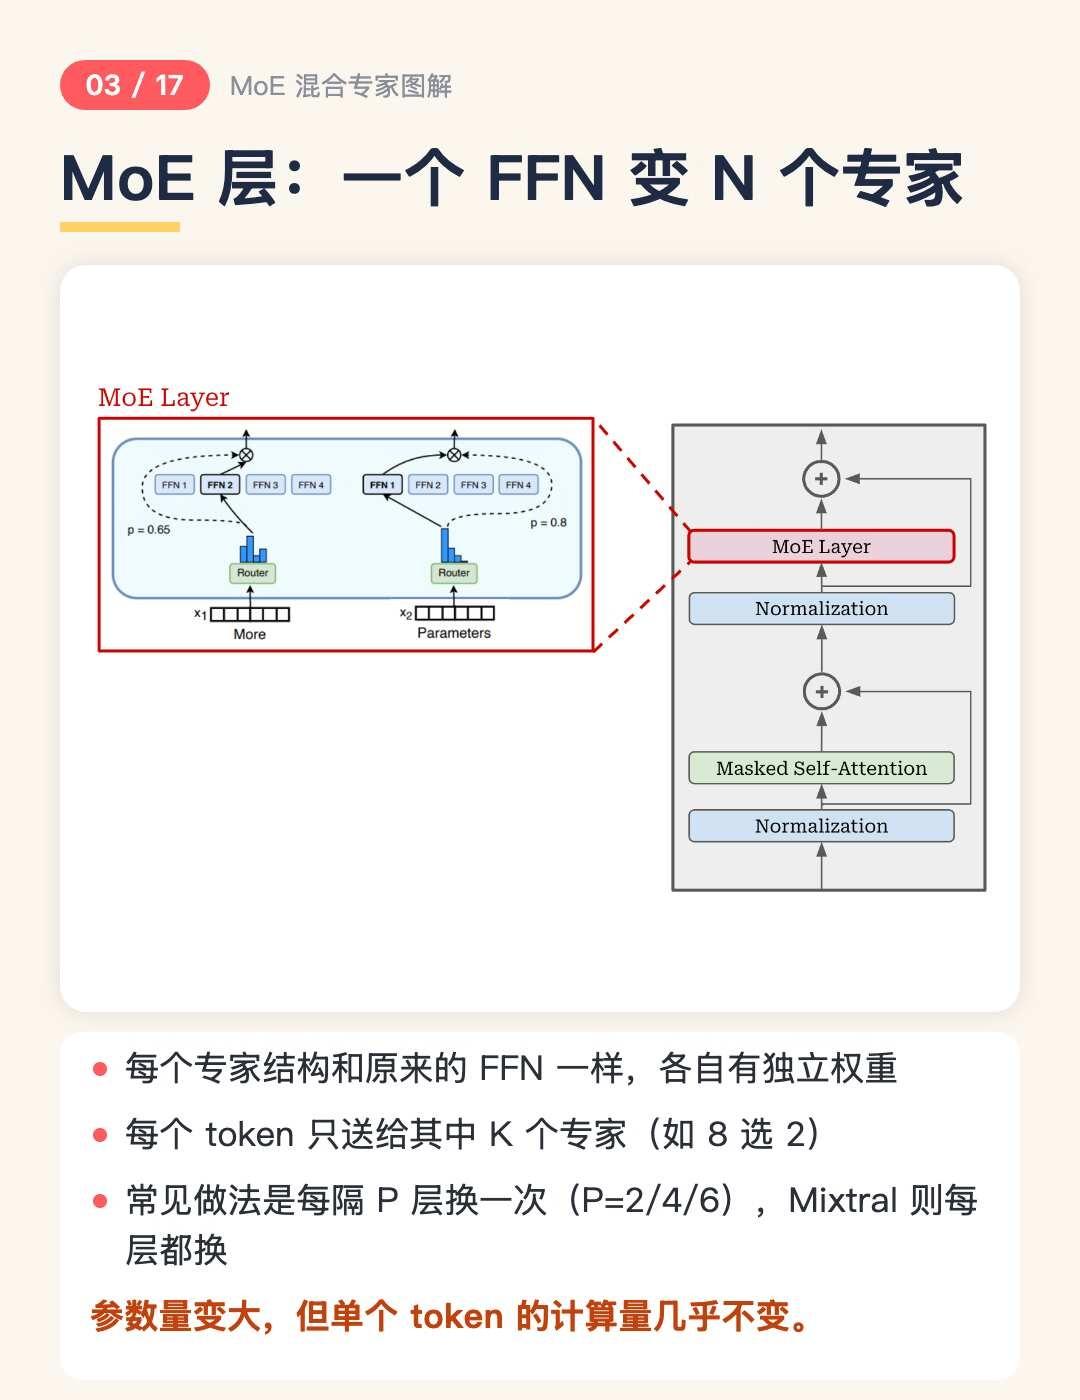
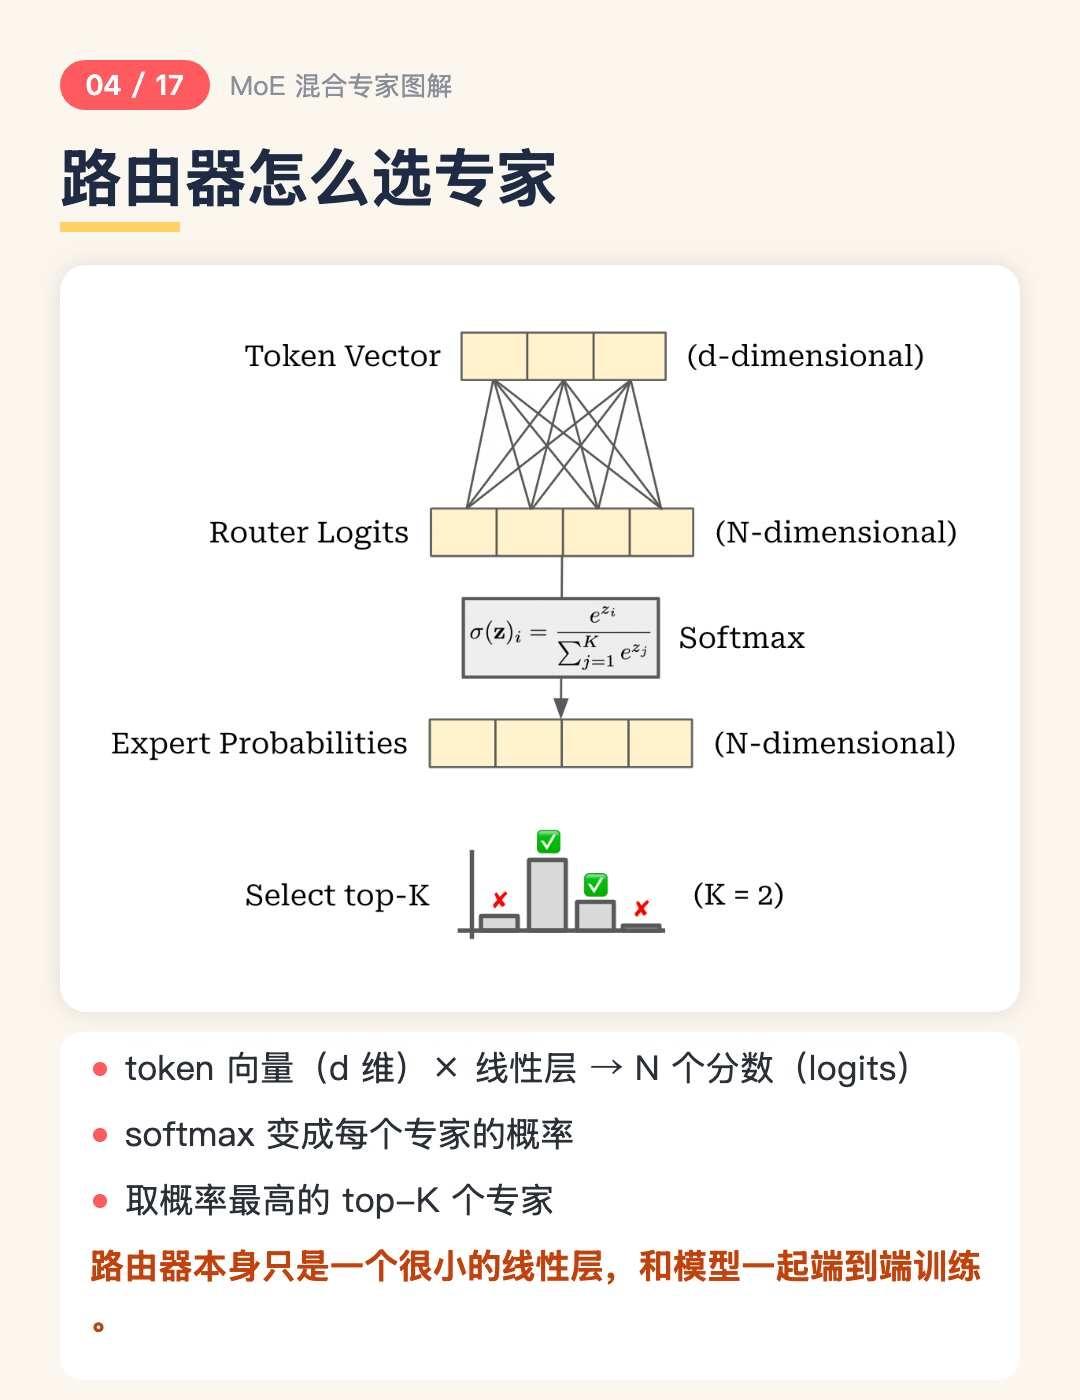
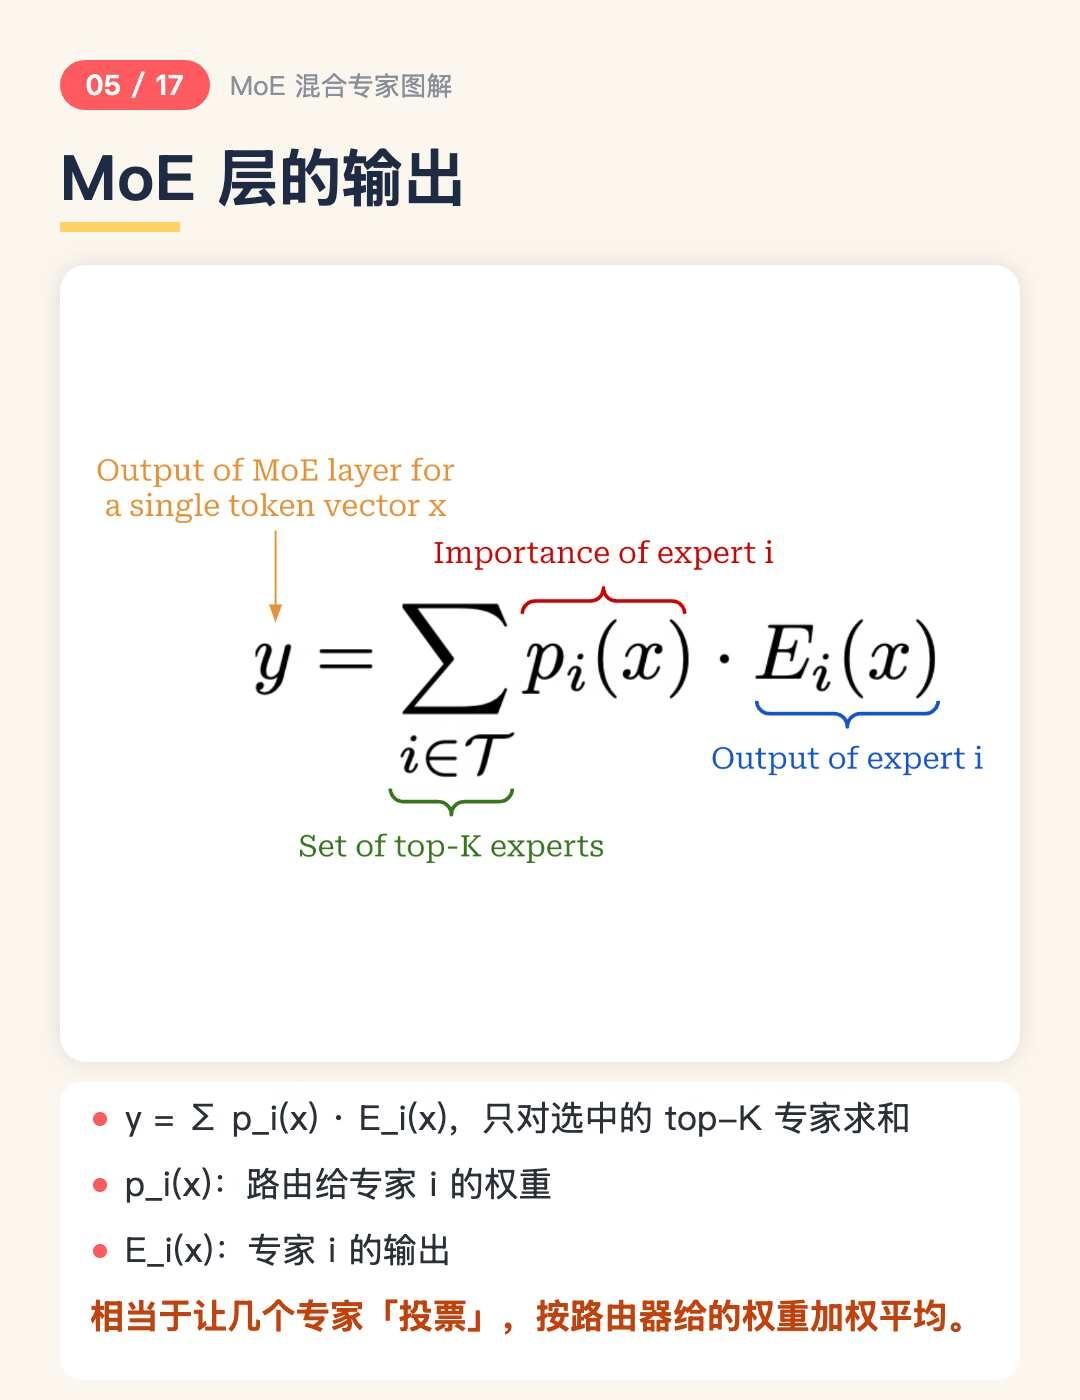
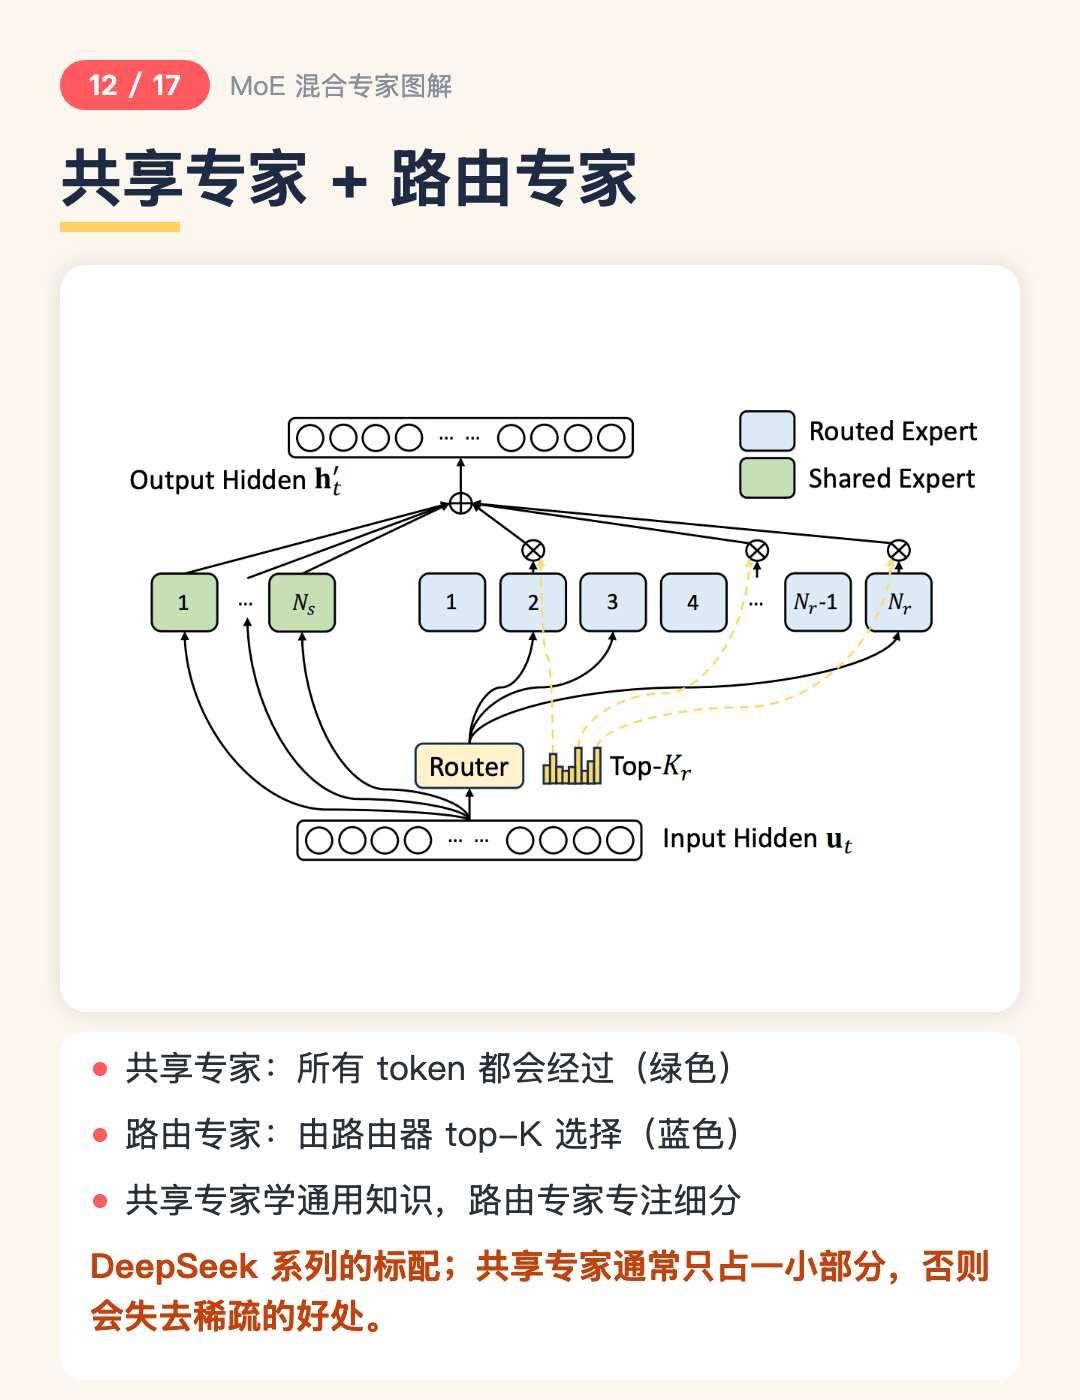
Transformer 里参数最多的是前馈网络 FFN,每个 token 都要过一遍。MoE 把一个 FFN 换成 N 个结构相同的「专家」,再加一个很小的路由器:token → 线性层 → softmax → 选概率最高的 K 个专家 → 按概率加权求和。
【MoE 有什么用】
· 总参数可以很大,但每个 token 只算 K 个专家,计算量只和「激活参数」有关
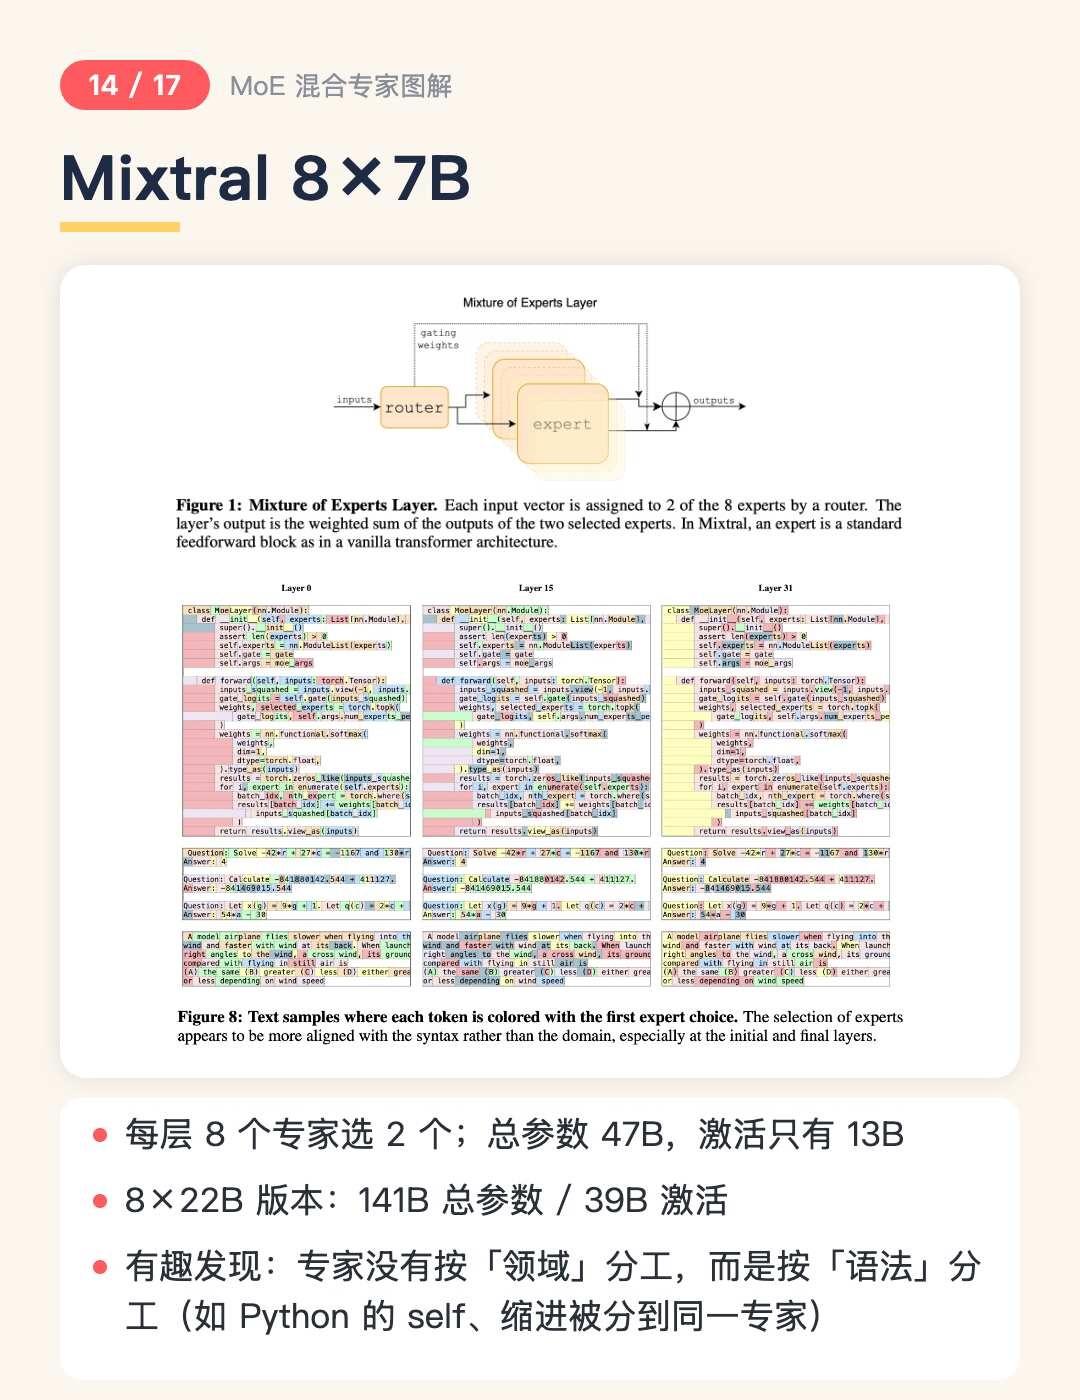
· Mixtral 8×7B:总参 47B,每个 token 只激活 13B
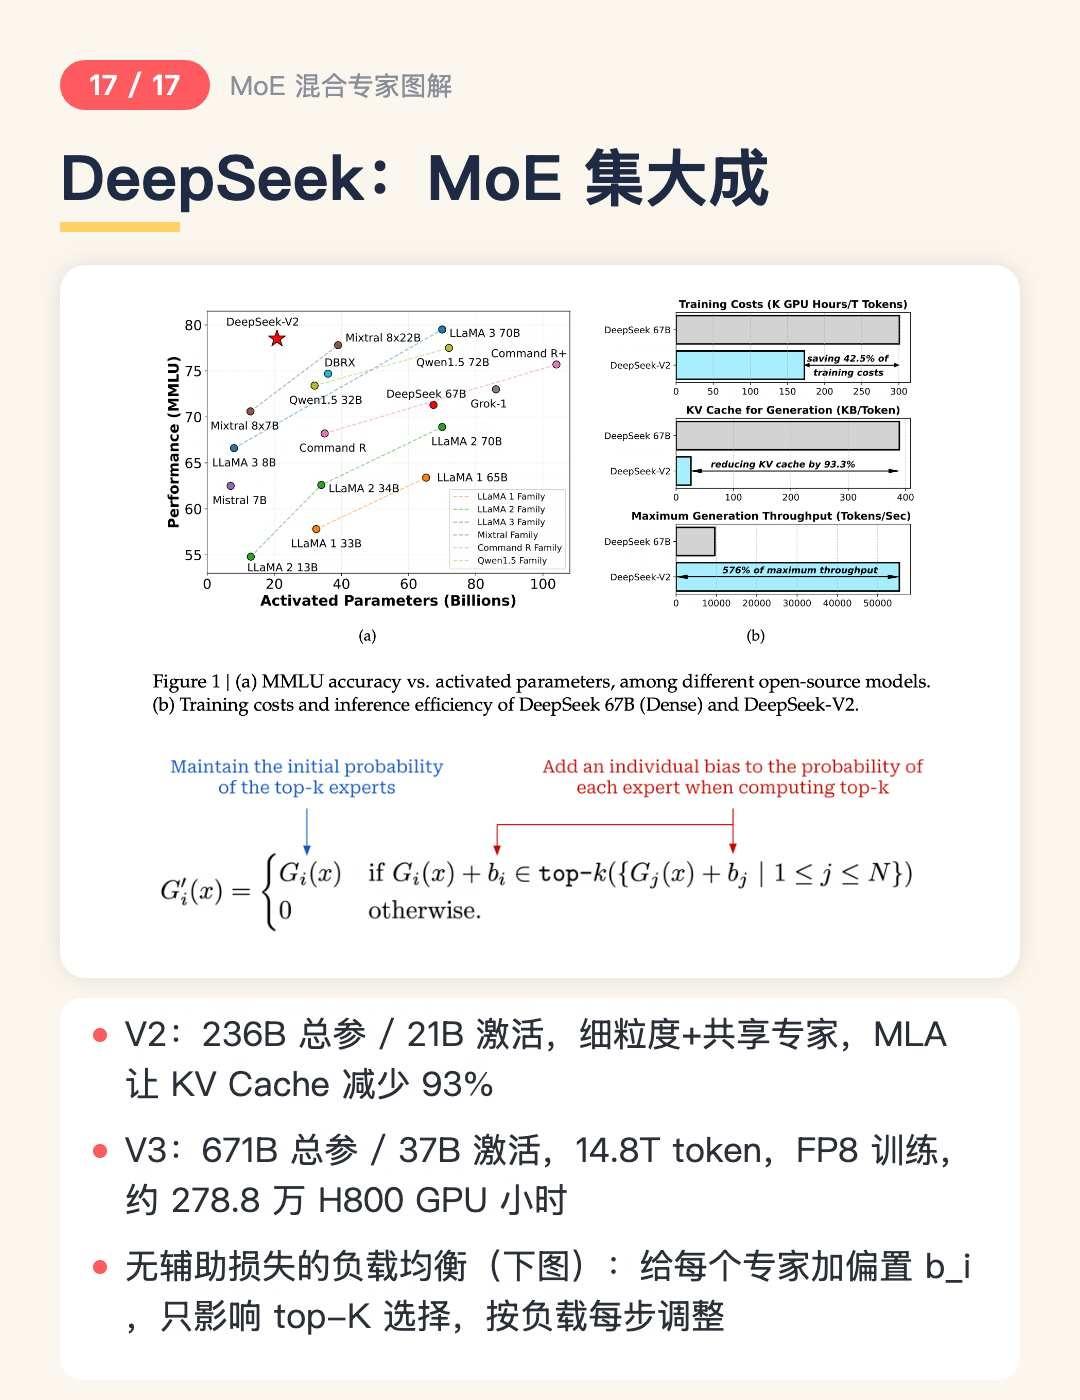
· DeepSeek-V3:总参 671B,激活只有 37B
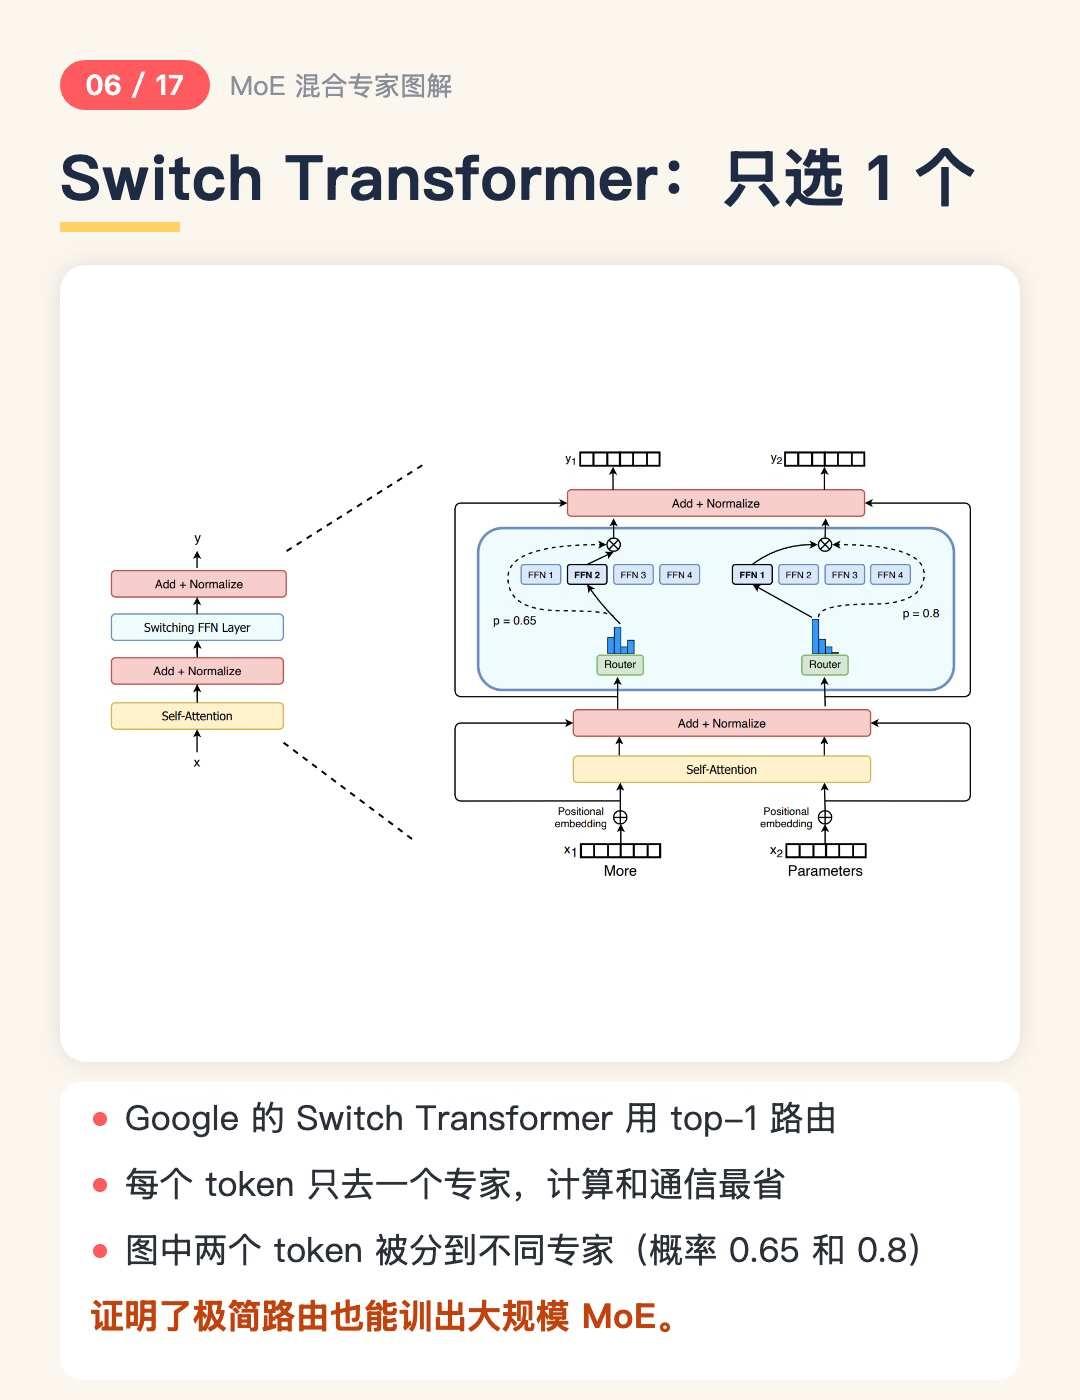
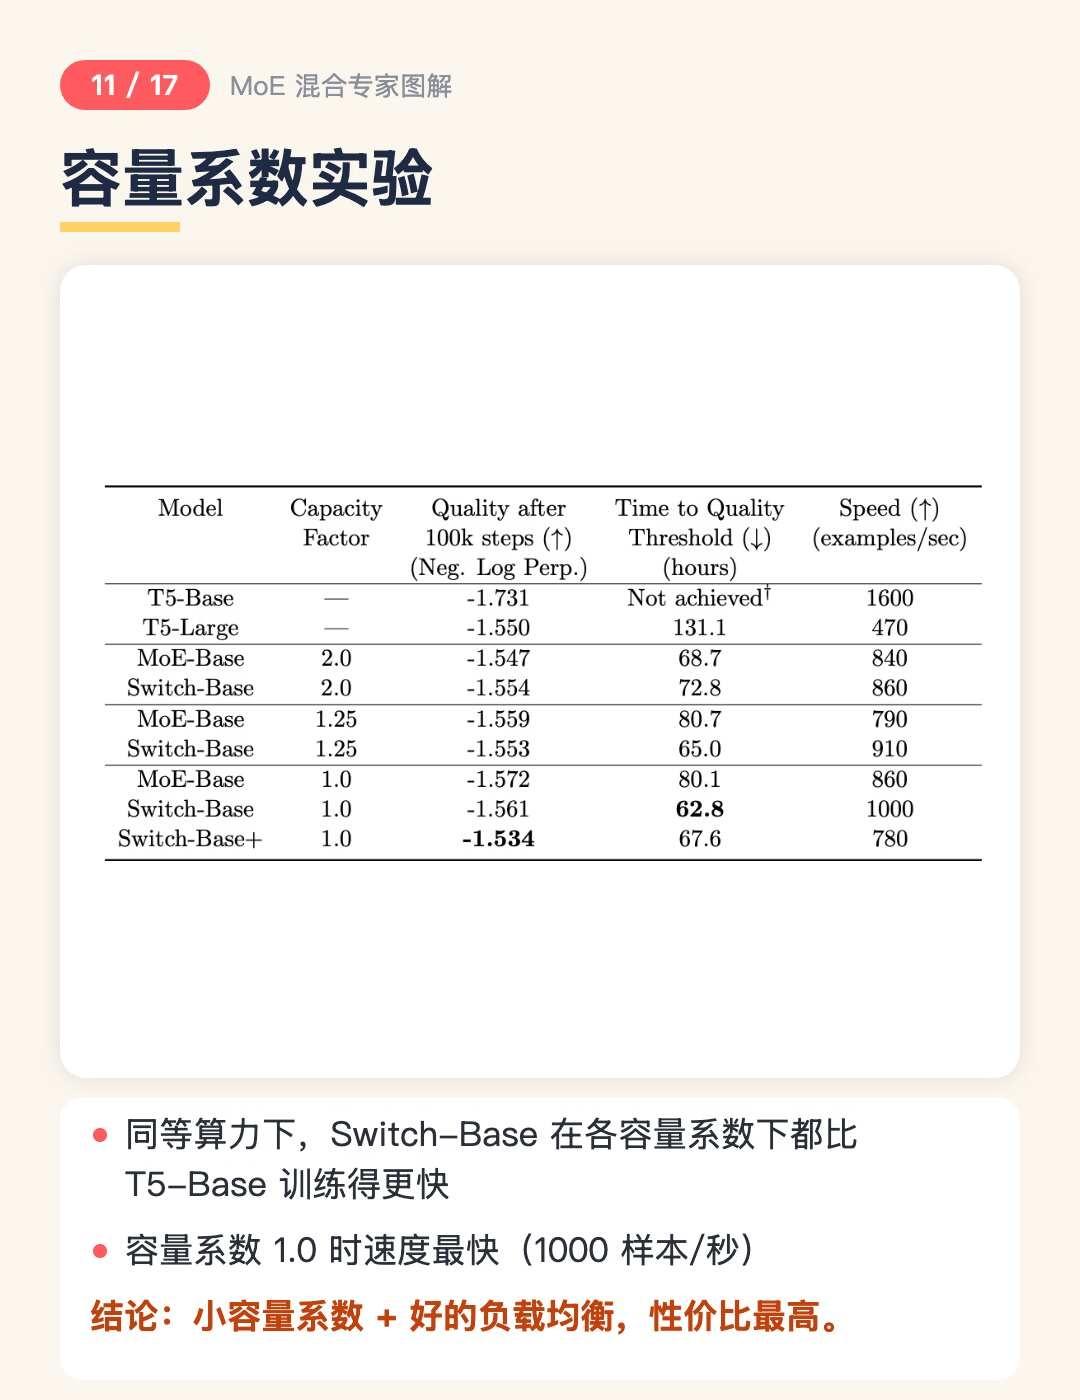
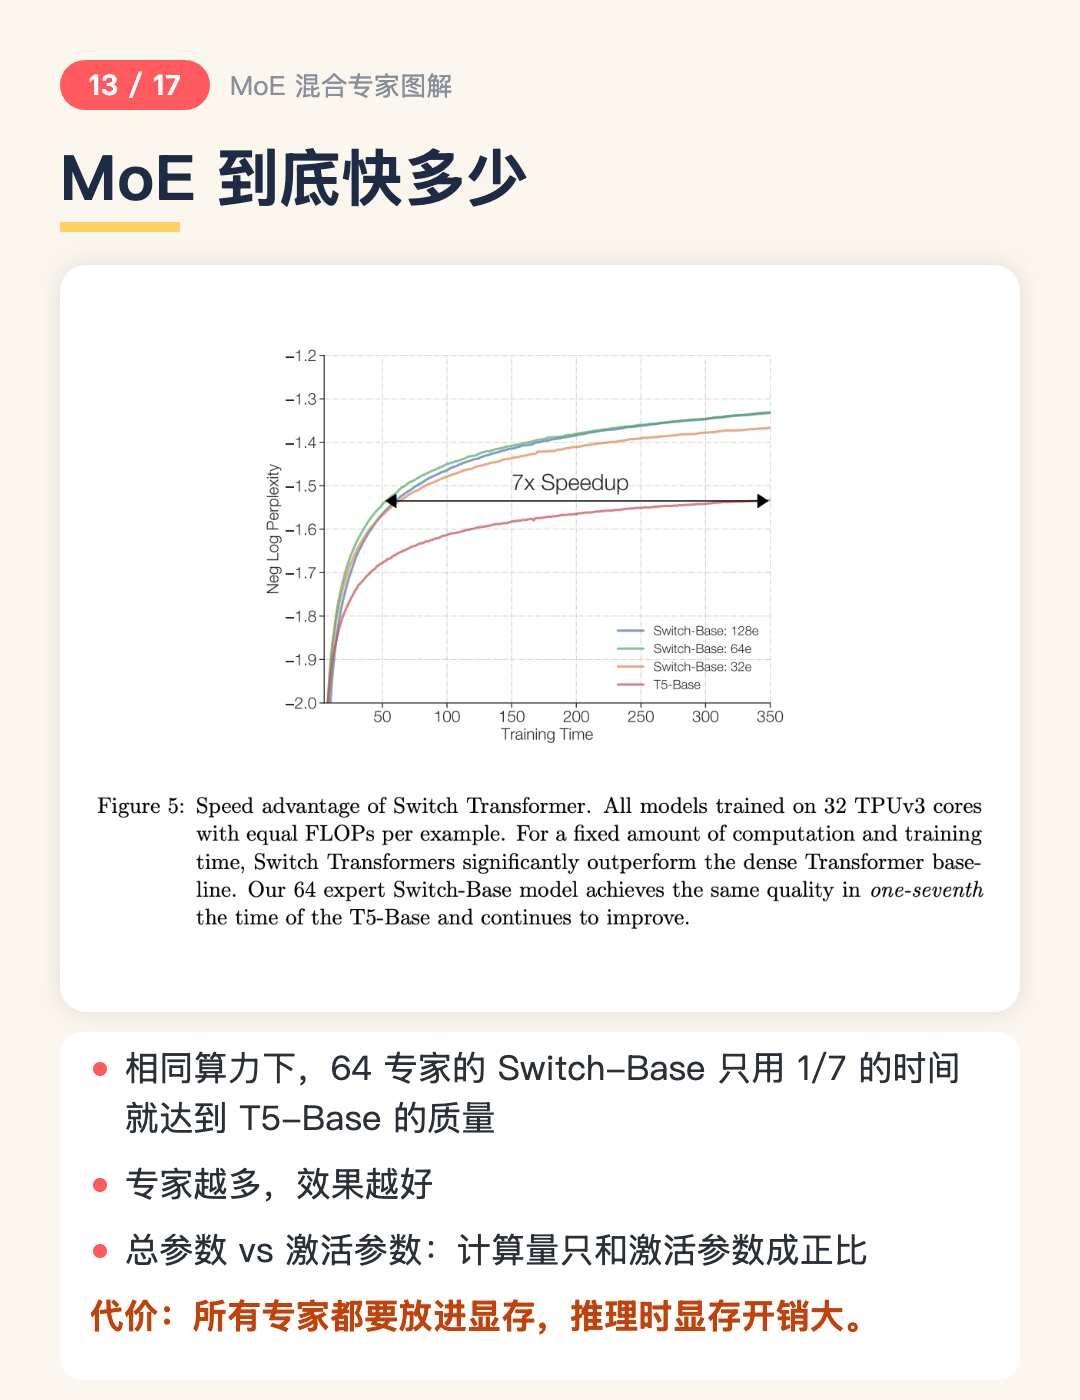
· 同等算力下,64 专家的 Switch Transformer 用 1/7 的时间就达到 T5 的效果
· 代价:所有专家都要放进显存,推理显存压力大
【训练难点和解法】
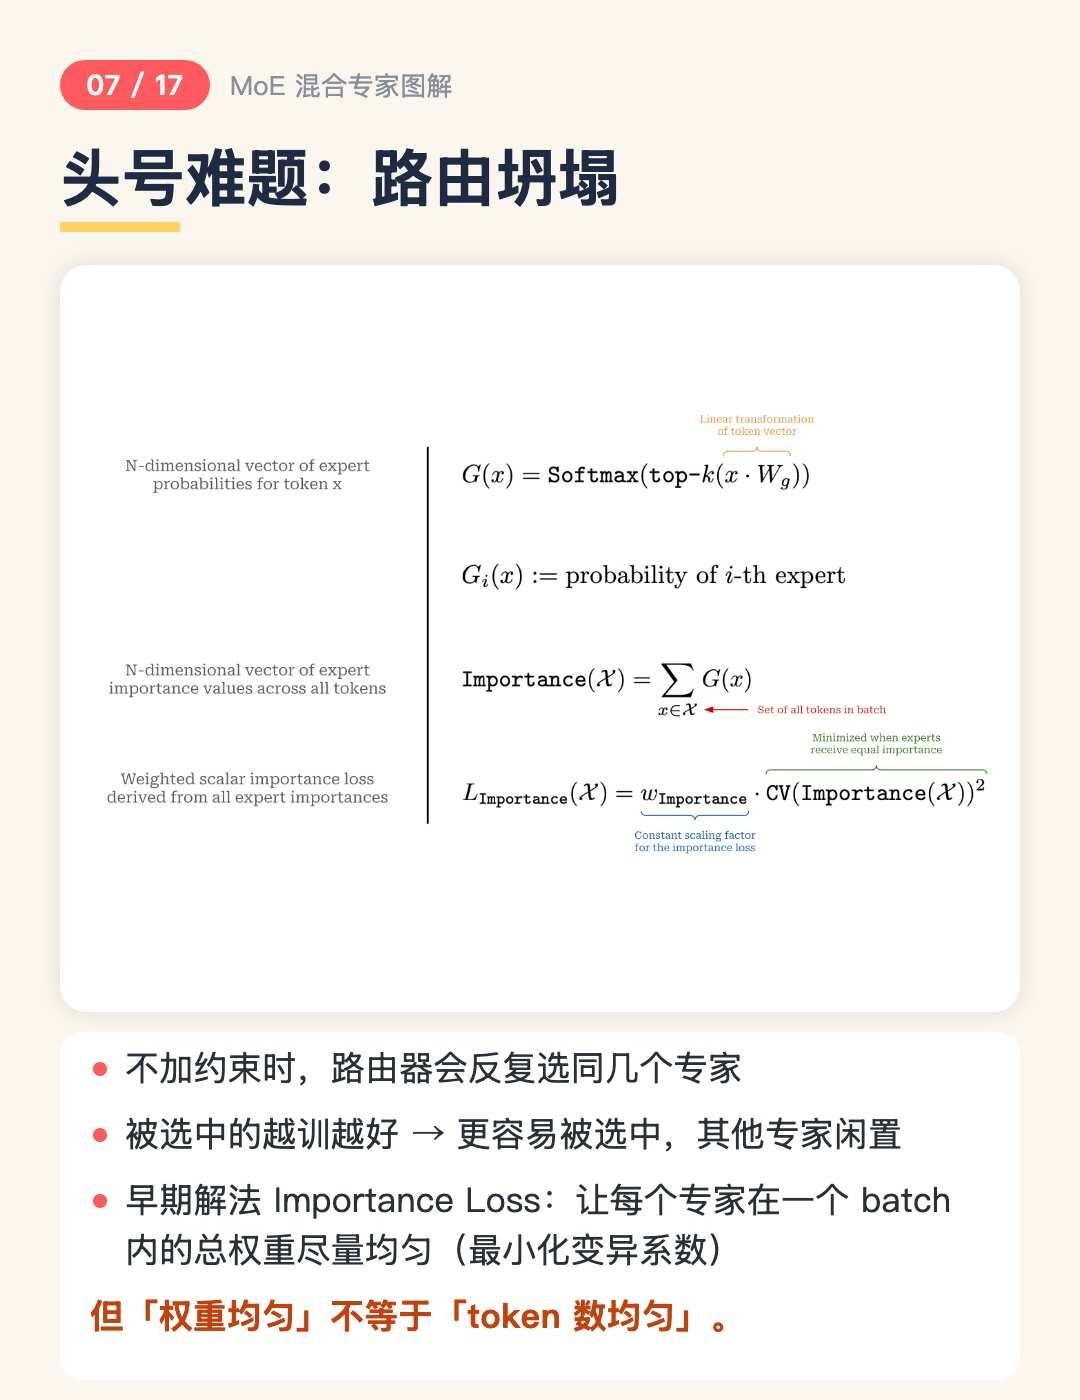
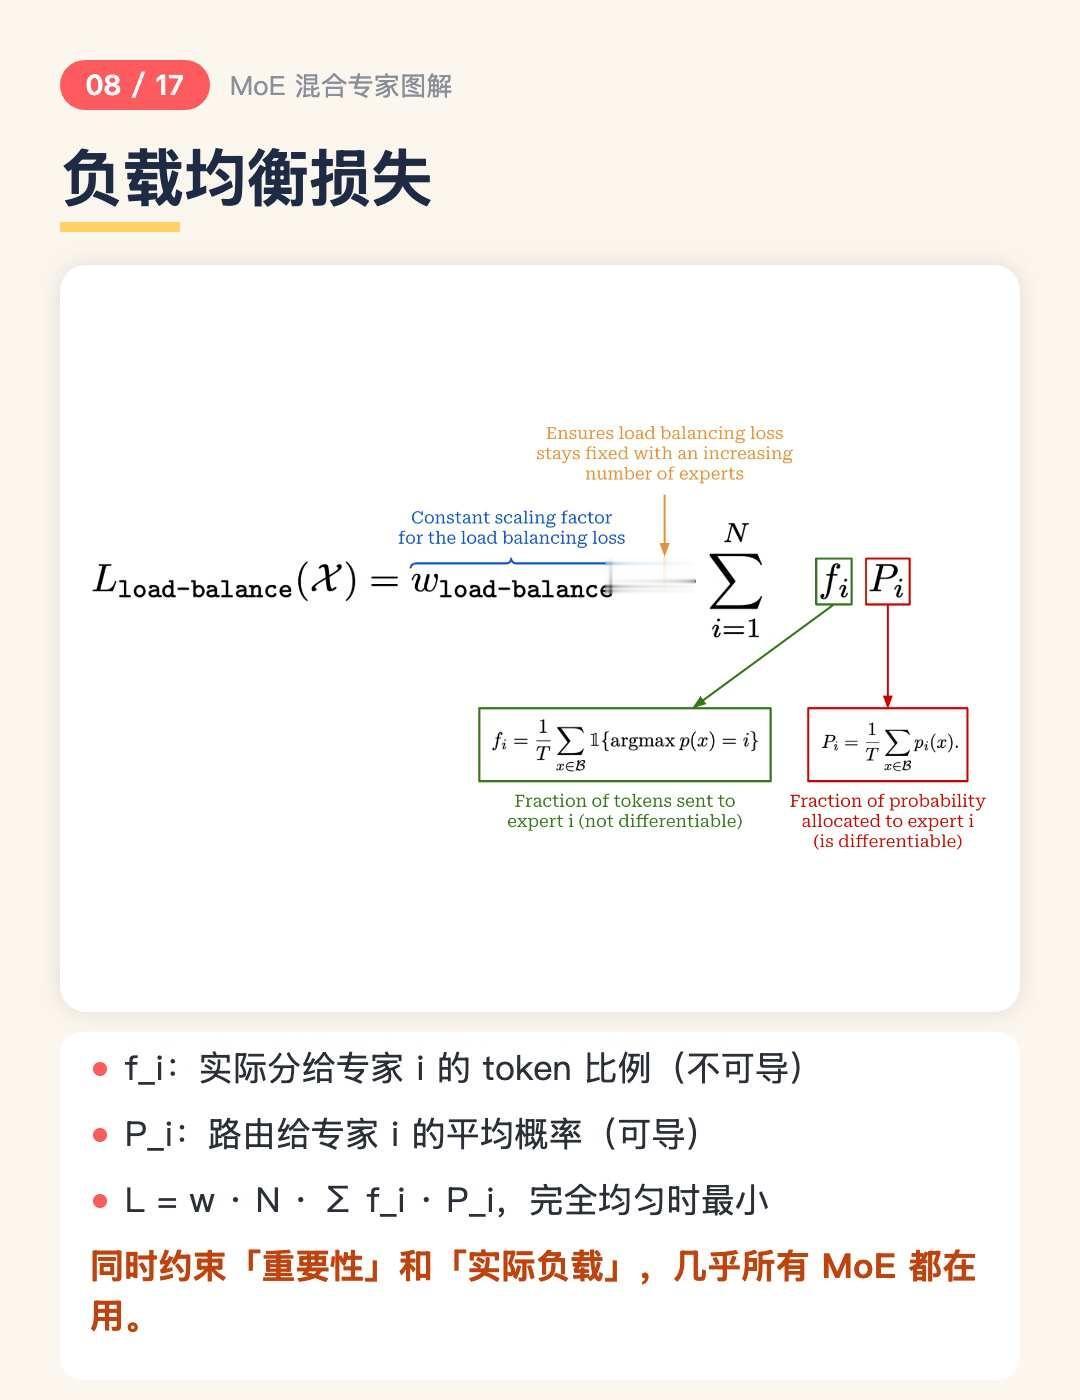
· 路由坍塌:总选同几个专家 → 用负载均衡损失(同时看 token 比例和路由概率)
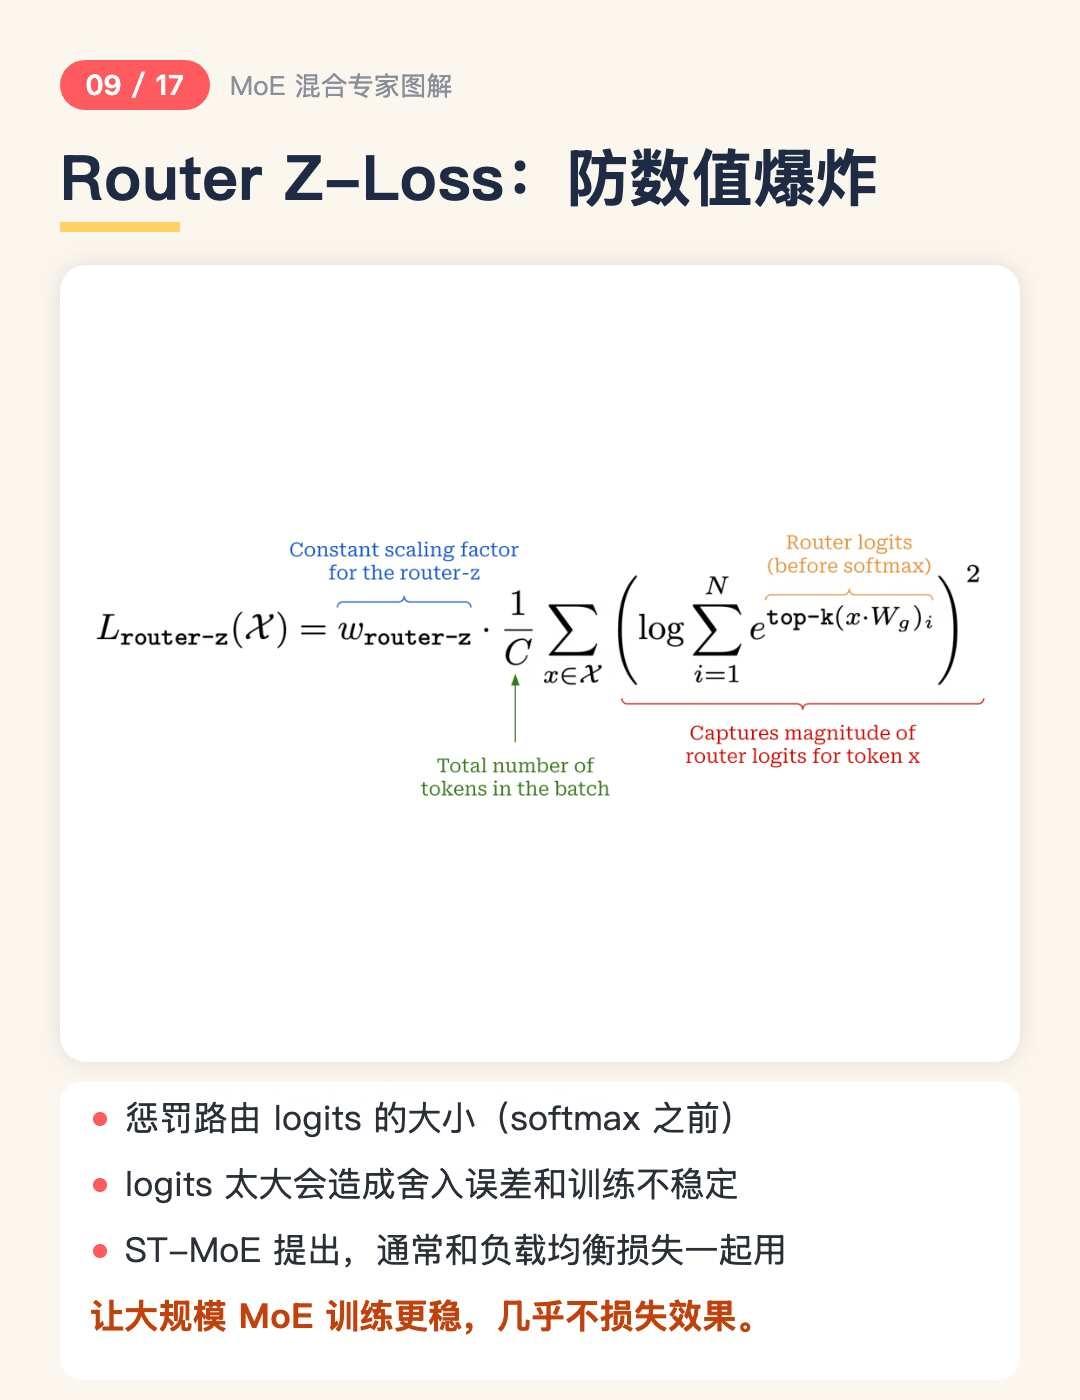
· 数值不稳:Router Z-Loss 惩罚过大的 logits
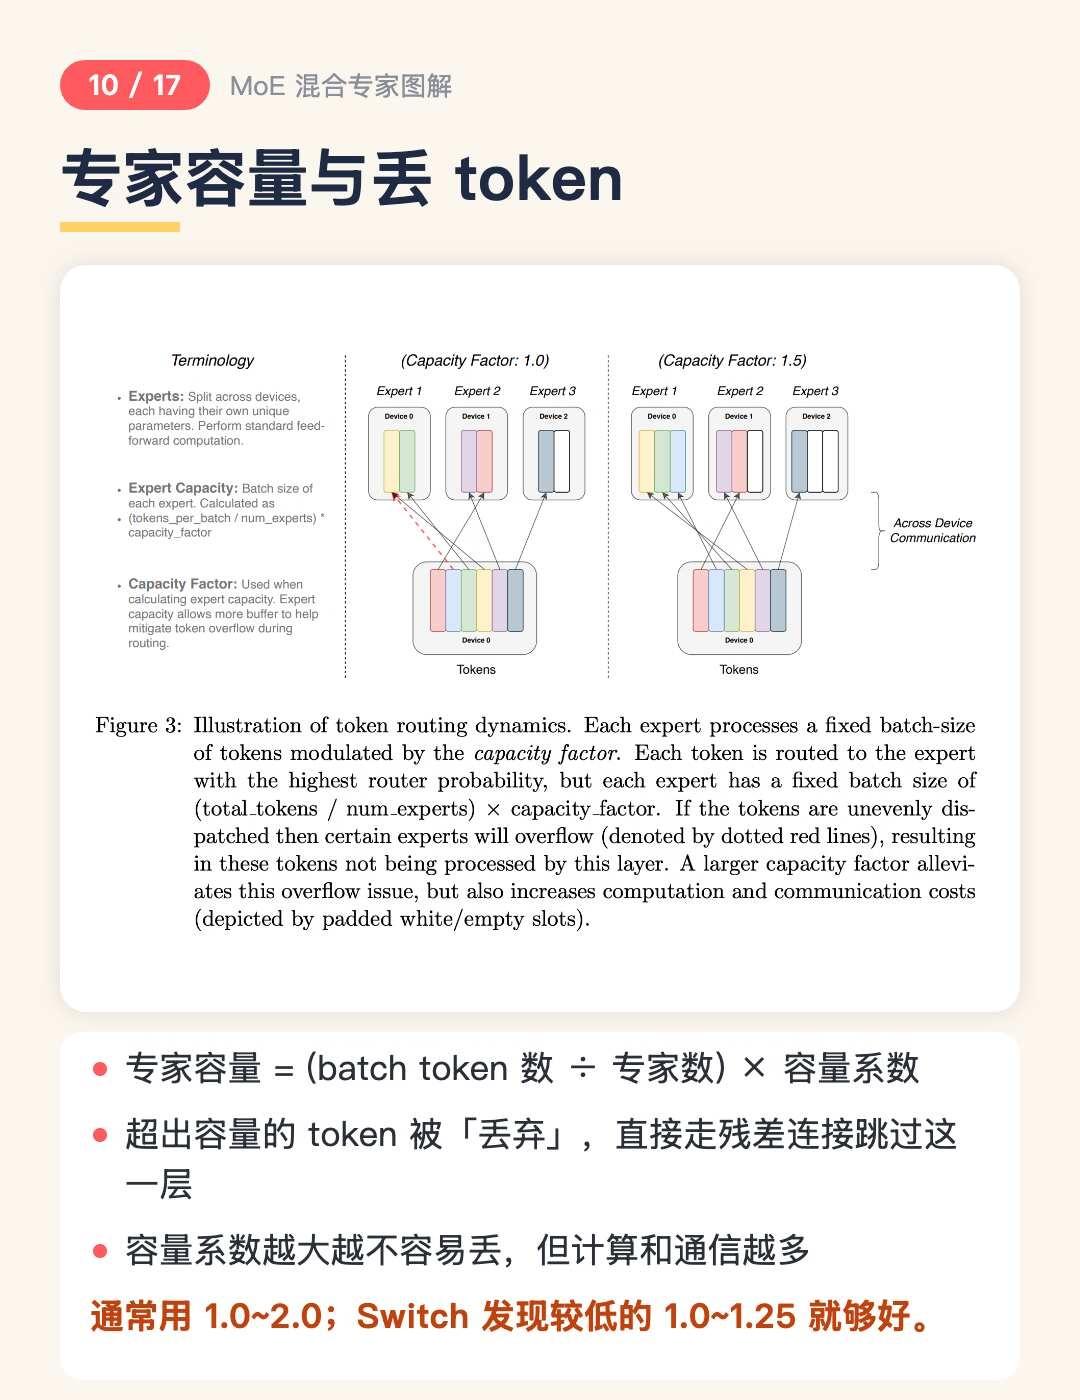
· 专家容量:超出容量的 token 被丢弃走残差,容量系数常用 1.0~2.0
· DeepSeek-V3:无辅助损失均衡,给每个专家加可调偏置
【架构演进】
· Switch:top-1 路由,极简
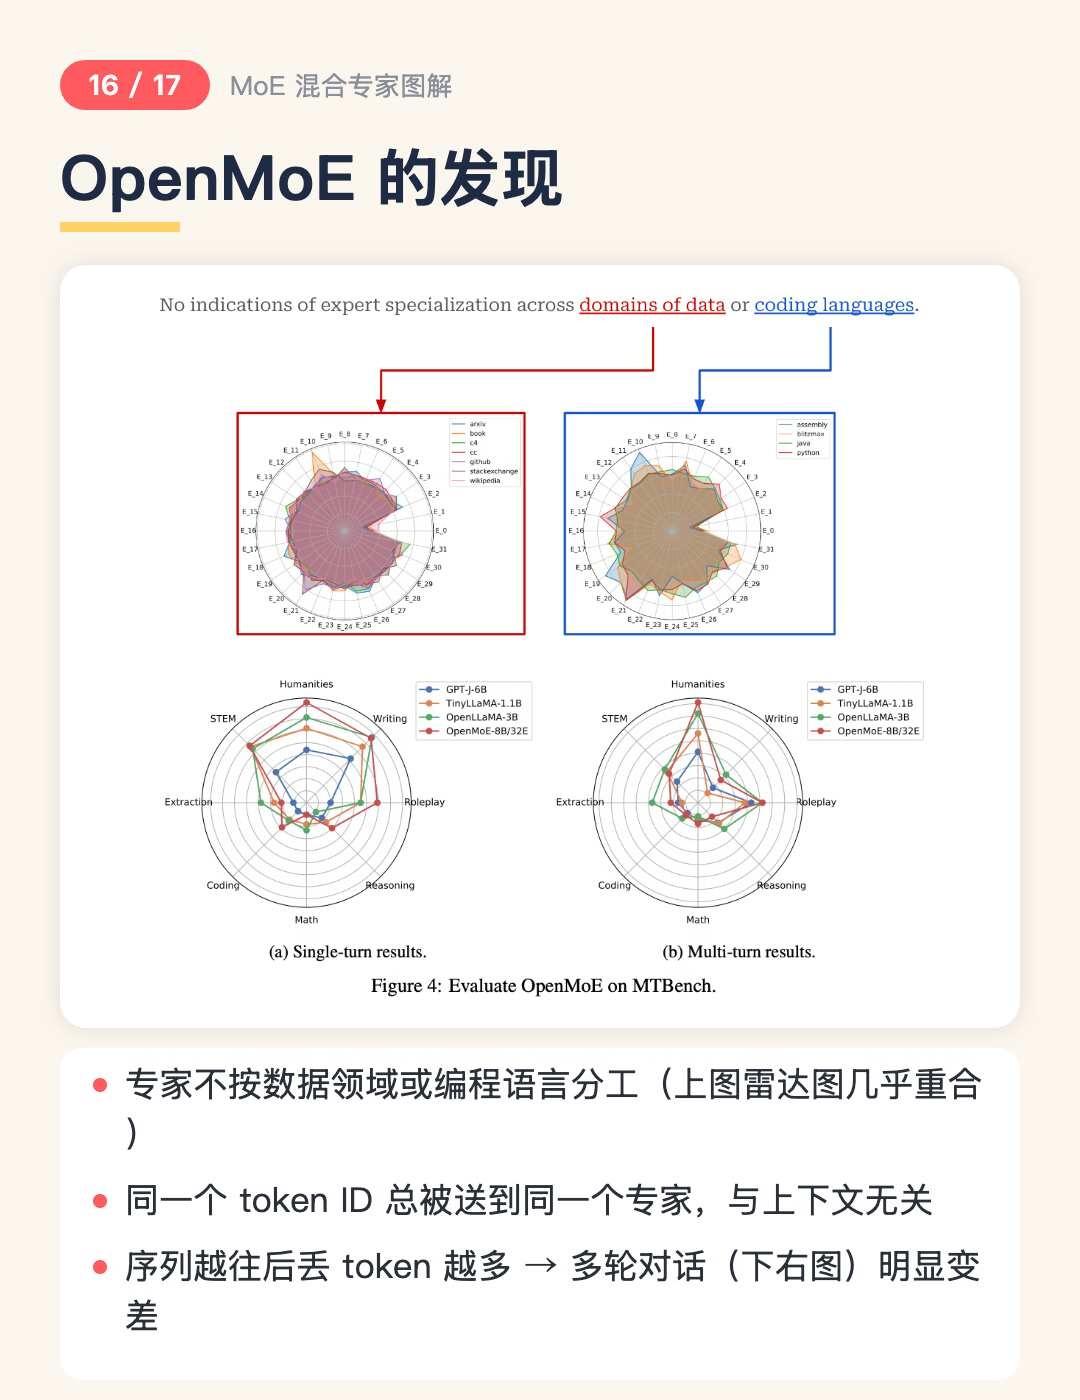
· Mixtral:每层 8 选 2;专家按「语法」而非「领域」分工
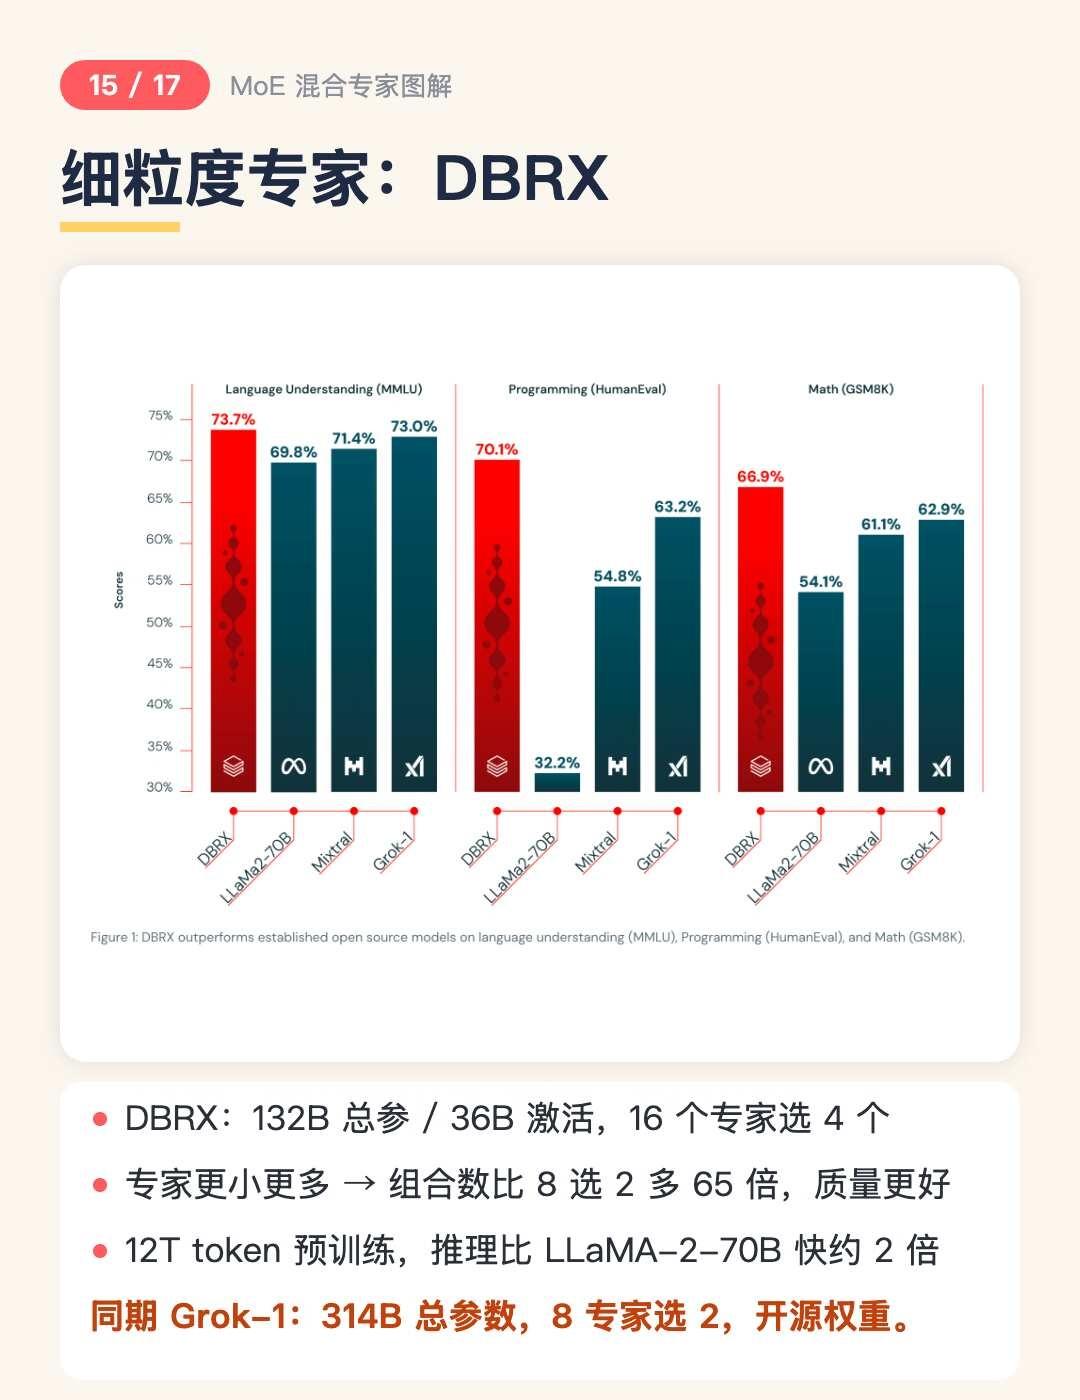
· DBRX:细粒度专家 16 选 4,组合数多 65 倍
· DeepSeek:细粒度 + 共享专家 + MLA,671B 模型约 278.8 万 H800 GPU 小时训完
💡 一句话:MoE 用「更多参数、同样计算」换更强的模型,关键在路由和负载均衡。
大模型 MoEDeepSeek LLM