美国说不定要栽在自己的语言上!说出来没人信,把美国医学生逼到崩溃的,不是复杂的专业知识,而是几十万个八竿子打不着的超长单词。
我看过不少美国医学院新生的吐槽,开学第一个月,专业课没听懂多少,光专业单词先硬背了一万多个。翻开医学教材,满页都是二三十个字母的长单词,长得像串乱码,看着都头疼。
就说个最简单的例子,葡萄是grape,葡萄干竟然是raisin。
俩单词长得没有半毛钱关系,词源一个来自日耳曼语,一个来自拉丁语,光看字面,你打死也猜不到葡萄干是葡萄做的。
不止这一个。猪是pig,猪肉是pork;牛是cow,牛肉是beef。活的动物是一个词,端上桌的肉又是另一个词,源头完全不搭边。
为啥会这样?说穿了就是历史留的烂摊子。当年诺曼人征服英格兰,上层贵族说法语,底层老百姓说盎格鲁撒克逊语。活的动物是底层人养的,用日耳曼词;端上餐桌的肉是贵族吃的,用法语词。
几百年过去,阶层隔阂没了,两套词汇全留了下来。好好一门语言,搞得像个大杂烩,日耳曼、拉丁、法语、希腊语什么都往里塞,越攒越多,越攒越乱。
现在英语的总单词量早就突破100万了,而且每年还在以大几千的速度往上涨。出来个新事物,懒得用旧词组合,直接造个全新的单词,越造越长,越生越偏。
我们大学四六级那点词汇量,放到专业领域连入门都算不上。美国人自己高中毕业,也就掌握两三万单词,看个深度新闻报道都费劲,更别说理工科、医学、法律的专业文献。
回头看看咱们的中文,完全是另一个路子,另一个格局。
国家语委早就有统计,2400个常用汉字,就能覆盖99%的日常书面语。就算加上次常用字,3500个一级规范字,足够应付一辈子的生活、工作、学习。
咱们的汉字是拼义的,不是拼音的。每个字都有自己的意思,拼到一起,新词你没见过也能猜个八九不离十。
比如“葡萄干”,哪怕你第一次见这个词,也知道是葡萄做的干果。“智能手机”,不用人解释也明白是带智能功能的手机。“新冠肺炎”,一看就知道是新型的、感染肺部的冠状病毒肺炎。
换成英语呢?每个新事物都可能蹦出一个全新的长单词,和旧词毫无关联,你没背过就是两眼一抹黑,啥也猜不出来。
就说医学里的“矽肺病”,中文三个字,看偏旁就知道和矿石粉尘、肺部疾病有关。英文是pneumoconiosis,整整15个字母,没专门背过的人,别说意思,连读都不一定能读顺。
我一直说,汉字的底层逻辑太高级了。几千年前就定下了“以形表意、组合造词”的规矩,不用不停造新字,用现有的字就能组合出无限的新词。
几千年来,汉字总数在慢慢涨,但常用字始终稳定在几千个。老祖宗传下来的这套体系,放到今天依然好用,甚至越到信息爆炸的时代,优势越明显。
到了AI时代,这套优势直接被放大成了降维打击。
懂点AI的人都知道,token是大模型的硬通货。同样大小的上下文窗口,能装多少token,直接决定了AI能处理多少信息、推理深度有多深。
语言学家早就测算过,单个汉字的信息熵接近10比特,单个英文字母才4比特左右。说白了,一个汉字承载的信息量,顶得上两个半英文字母。
同样一段意思,中文用的字符更少,消耗的token更少。同样的上下文窗口,中文能塞下更多的指令、更多的资料、更复杂的逻辑。
有海外技术机构做过测试,同样的专业技术文档,中文版本消耗的token,比英文版本少三分之一还多。这意味着什么?意味着用中文调用AI,更省钱、速度更快、能处理更复杂的问题。
更关键的是,中文的组合造词能力,在AI推理里太好用了。遇到新概念,用现有汉字组合一下就清楚了。英文呢?要么造个又臭又长的新词,要么用一长串单词去解释,平白浪费算力。
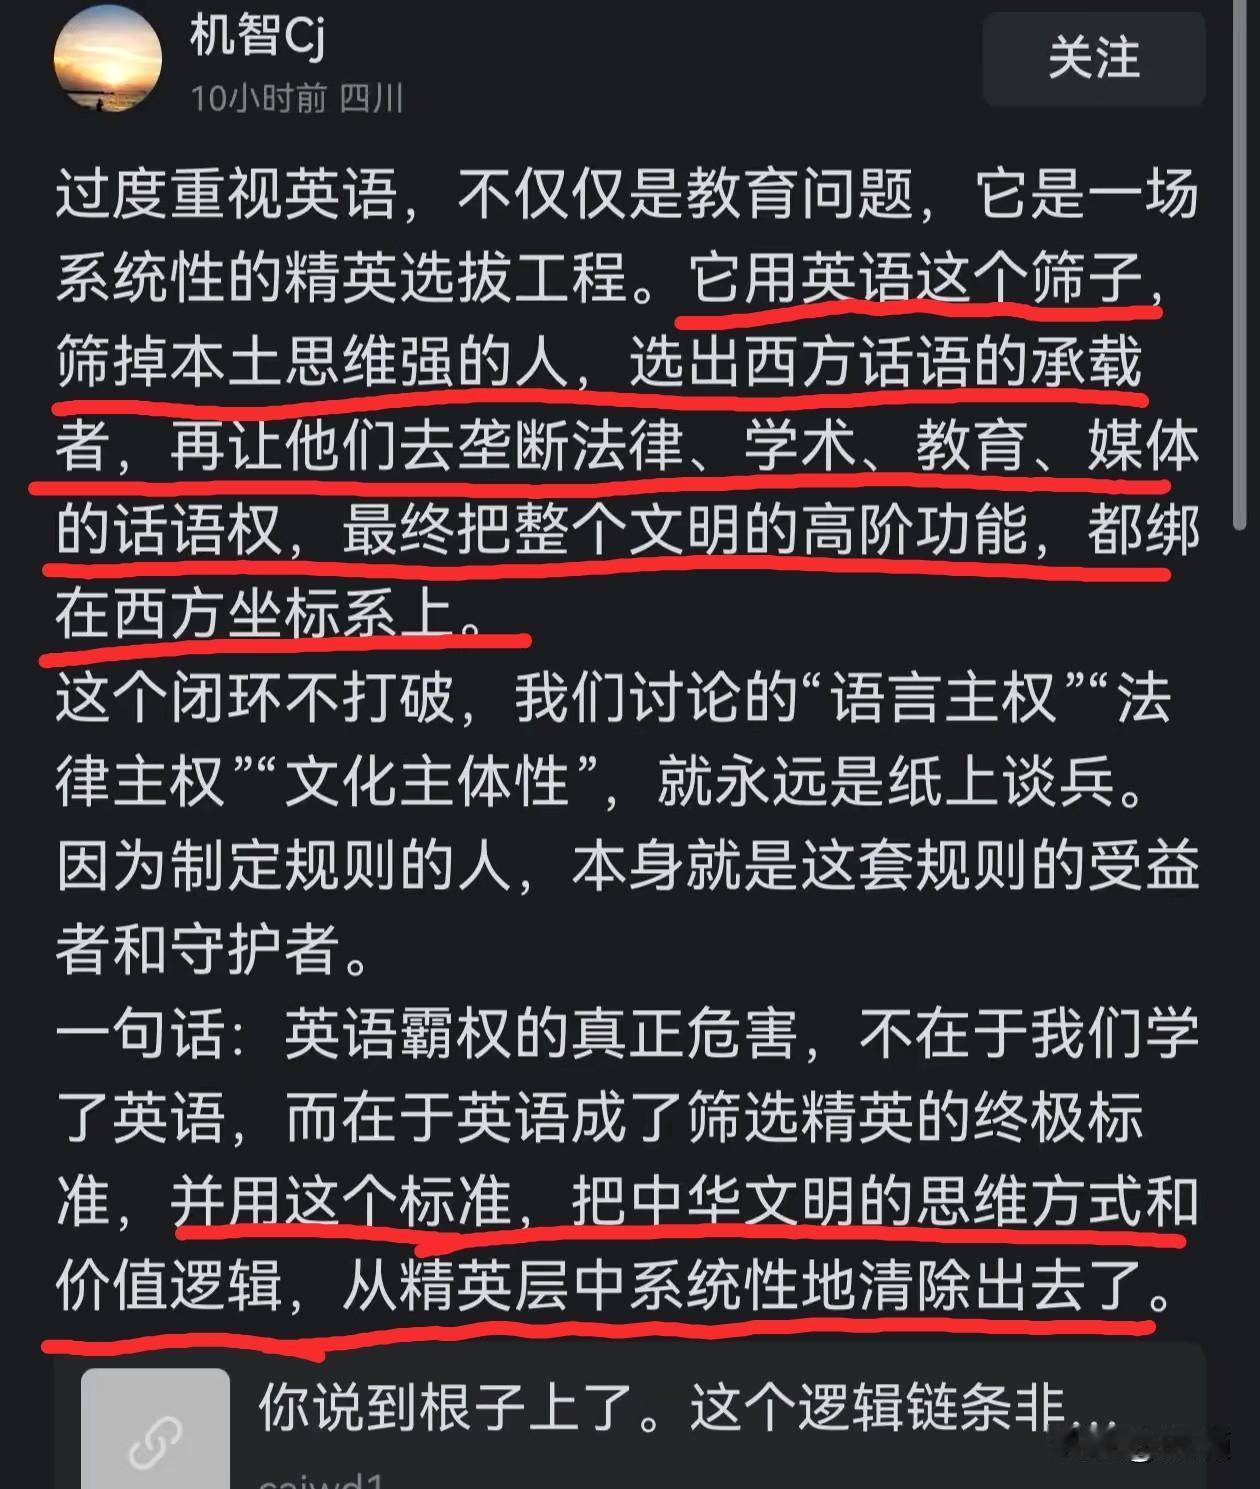
有人说英语是世界语言,地位不可撼动。可我要说,语言的本质是工具,谁效率高,谁就能适应新时代。
过去几百年,英语靠着殖民扩张和科技先发优势传遍世界。可到了AI爆发的今天,它自身词汇臃肿、构词低效、体系割裂的毛病,全暴露出来了。
现在的美国,医学生还在死背几十万长单词,普通人还在被专业术语挡在知识门外。他们的语言,正在慢慢变成社会进步的拖累。
而咱们的中文,靠着老祖宗留下的这套底层逻辑,靠着2400个常用字就撑起整个文明的高效体系,正在AI时代爆发出惊人的生命力。
这不是什么民族自大,是明摆着的事实。信息越爆炸,知识越迭代,中文的效率优势就越突出。
早晚有一天,所有人都会看清,在真正的智能时代,被自己的语言拖垮的,恰恰是那个天天喊着自己领先的美国。