AI芯片,为什么开始“分工”了?
过去看AI芯片,大家习惯只看一个数字:
峰值算力。
但大模型时代,这个逻辑正在发生变化。
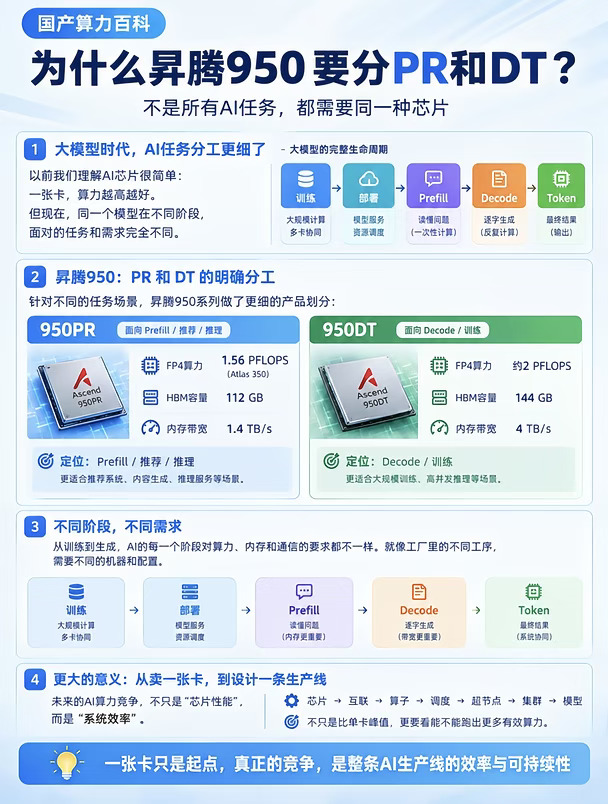
因为一个模型从训练到最终输出Token,中间其实要经历很多不同的阶段:
训练 → 部署 → Prefill → Decode → Token
每个阶段,对计算、显存、带宽和通信的需求都不一样。
比如Prefill,更像是“把用户的问题一次性读进去”,计算密度高;
Decode则是“一个Token一个Token地往外生成”,对显存访问和带宽更加敏感。
所以,昇腾950没有简单地追求“一张卡包打天下”,而是出现了更加明确的产品分工:
950PR:偏Prefill、推荐、推理
950DT:偏Decode、训练
这其实透露出一个很重要的趋势:
AI芯片正在从“通用算力竞争”,走向“场景效率竞争”。
未来的数据中心,可能不再是一堆完全相同的AI卡。
而更像一条生产线:
有人负责训练模型,
有人负责模型推理,
有人负责Prefill,
有人负责Decode,
最后共同完成Token生产。
因此,判断一套AI算力系统,不能只问:
“这张卡有多少PFLOPS?”
还要问:
“它最适合干什么?”
因为真正决定成本和效率的,往往不是理论峰值,而是:
在具体任务里,能把多少算力真正变成Token。
这也是国产算力竞争正在进入的新阶段:
从比芯片参数,走向比系统效率。
#国产算力 #昇腾950 #AI芯片 #大模型 #智算中心 #国产算力百科