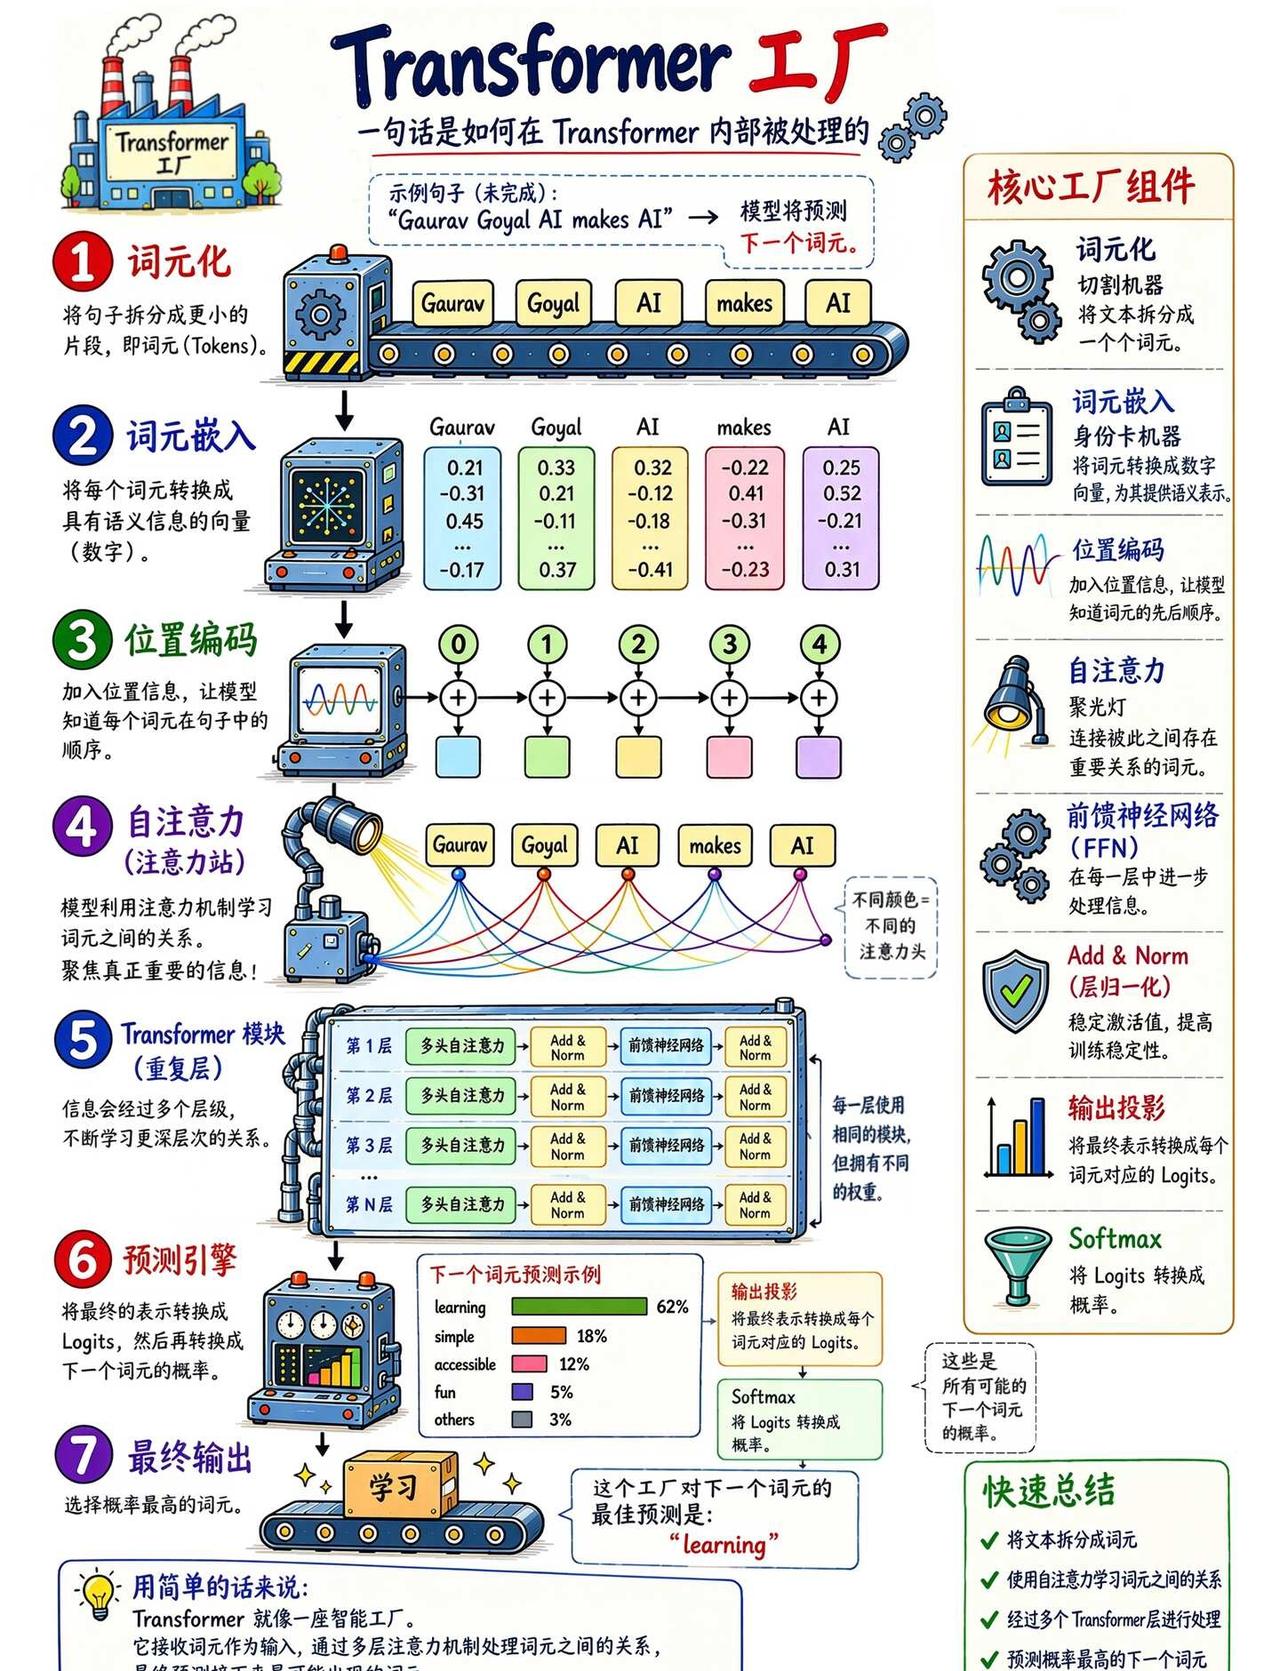
一张图看懂Transformer智能工厂
Transformer 就像一座精密的智能工厂:先把文本拆成一个个词元,再将词元转换成向量并加入位置信息;随后通过自注意力捕捉词元之间的关联,让信息在多层 Transformer 模块中不断加工与提炼,最后经过输出投影和 Softmax,将模型的理解转化为概率分布,从所有可能的下一个词元中选出概率最高的一个。从 Token 到 Attention,再到 Next Token Prediction,这就是大语言模型“读懂上下文、预测下一个词”的核心流水线。