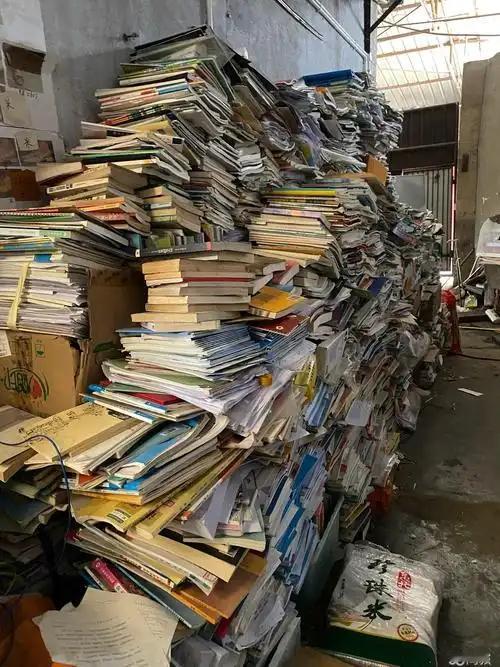
日本古书界最近出现一批神秘买家,从历史、哲学、医学、法律到偏远地区地方志,见书就收,订单成箱发往同一类跨境中转站。古书商起初以为遇上了大收藏家,后来才发现,这场扫货原来是一场数据争夺!
一位店主一天卖出上百本,许多冷门旧书突然被批量下单,甚至几十年前的政治小册子也有人要。报道提到,大量日文实体书被运往海外,重量按吨计算。
书一旦进入工业扫描流程,纸上的内容就会变成图片、文字识别结果和可供模型学习的数据集,几代人留下的知识随之被装进服务器。
为什么AI公司会把目光从网页转向旧书堆?答案藏在训练数据的质量里。互联网上的文本数量极大,广告软文、重复转载、营销话术和机器生成内容也越来越多。
大模型需要的是结构完整、语言规范、信息密度高、带有人类真实思考痕迹的文本,旧书恰好符合这些条件。
地方志尤其有价值。它记录地名沿革、产业变化、家族迁徙、灾害记忆和地方制度,很多内容从未完整数字化。
一本旧医书、一本地方出版的法律汇编、一本昭和时期的行业报告,看似只服务过一小群读者,放进数据视角里,却像一块未经反复开采的矿石,带着独特的语言和历史细节。
扫描旧书的流程很直接。批量购入后,部分书籍会被拆开书脊,页面送进高速扫描设备,再经过文字识别、清洗、标注和去重。
几十万字的纸质内容很快变成电子文件,接着进入更庞大的数据工程。看着像古董摊上的旧纸堆,走完流程后就成了科技公司眼里的“数据原油”。
Anthropic此前的案件,把这条产业链照得很清楚。公司曾购入实体书进行扫描,也因盗版书训练与作者达成巨额和解。
行业由此看到一个现实,模型训练需要海量文本,版权、来源和数据使用边界也会跟着成为最难绕开的成本。书买下来以后,文本如何进入模型,依然需要清晰的权利安排。
在我看来,纸质书重新被追捧,恰恰说明高质量的人类知识从未过时。网页更新速度快,旧书保存的是经过编辑、校对和长期沉淀的表达。
尤其是专业书、地方资料和绝版出版物,里面的错误率、上下文和叙事完整度,往往比碎片化网络文本更适合深度处理。
更重要的是,AI生成内容正在反过来填满网络。研究者把模型反复学习机器生成内容可能带来的性能退化称为“模型坍塌”,核心风险在于真实世界的稀有信息逐渐被重复模式覆盖。
行业因此更珍视来源清楚、由人类创作、带有原始细节的数据。旧书的价值,也在这个时刻被重新定价。
可真正值得注意的还在后面。旧书首先是文化遗产,其次才是可利用的数据。普通二手书批量数字化能够扩大知识传播,孤本、签名本、地方档案和脆弱纸张则需要更谨慎的保护。
数据采集速度越快,图书馆、书店、出版机构和公共部门越需要建立筛选、留存和数字备份机制。
我反倒觉得,最值得珍惜的是每本书在扫描前后留下可追溯的来处。
谁写的,何时出版,原件在哪里,文本以何种授权进入数据库,这些问题关系到作者权益,也关系到人类未来如何追溯知识的源头。模型能吸收文字,文明还需要记得文字从哪里来。
这场旧书热也给中国提了个醒。中文古籍、地方文献、行业资料和近现代出版物数量巨大,数字化工作早已持续推进。
未来更需要把保护、整理、开放利用和版权管理放在一张图上考虑。让珍贵文献得到专业保存,让公共知识资源在规则内发挥价值,才能把纸上的财富变成长期能力。
归根结底,大模型“吃书”看似科幻,背后却是竞争:谁掌握更丰富、更干净、更有来历的知识,谁就拥有更扎实的智能底座。
旧书翻开的每一页,都曾服务于某个时代的人。如今它们又走向新的机器世界,保存好原件、讲清楚权利、用好其中的智慧,才是这场数据争夺最该守住的底线。