🔥 vLLM 正在把 DiffusionGemma 改造成Jev“决策机器”,实测数据全曝光
家人们,这个 PR 信息量太大了,我帮你们把关键点全部拆出来👇
🎯 这个 PR 到底在做什么?
把 DiffusionGemma 26B MoE 变成一个 Jev 风格的“并行决策引擎”——不逐字生成,直接在一次前向传播里,对所有选项同时给出概率和置信度。
核心操作是:预填一个“画布”(canvas),把问题模板和选项槽位固定好,让模型只对“待填位置”去噪,一次读出所有答案的 logprobs。
⚡ 实测数据(DGX Spark + RTX 5090)
DGX Spark(作者测试):
· 1 路并发:8.7 req/s,0.12 秒
· 32 路并发:54.0 req/s,0.58 秒
· 约 162 决策/秒
RTX 5090(社区实测):
· 1 路:6.5 req/s,154 ms
· 16 路:25.4 req/s,372 ms
· 600 次决策:p50 140 ms
🧠 准确率测试(重点看这个)
编程语言识别:10/10 全对,p(want) 基本都在 0.97 以上
人类语言识别:9/10,唯一 MISS 是葡萄牙语被认成法语,p(want)=0.47±0.11——模型自己给出了低置信度,这个不确定性信号是准的
单位比较:10/12,两次 MISS 的 p(want) 分别是 0.20 和 0.19——同样,置信度低的时候确实容易错
视觉能力(多模态)也很能打:
· 颜色识别:8/8,所有尺寸全对
· 计数:4/4
· 象限定位:大部分 4/4,右下角 3/4(p=0.51)
· 对比度判断:低对比度 +2 时 6/8,+4 以上全对
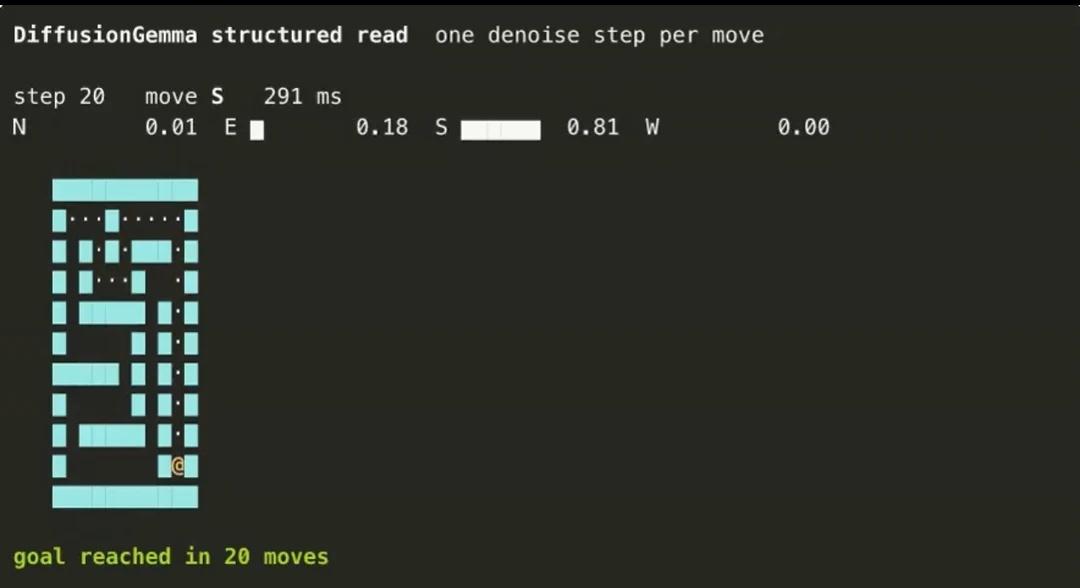
用 N/E/W/S 四个选项解 ASCII 迷宫,也能跑。
🛠️ 新增的三个 API 参数(走 vllm_xargs)
· diffusion_seed_canvas:预填画布,把问题模板写进固定位置
· diffusion_max_steps:去噪步数,设为 1 就是“一次出结果”
· diffusion_read_only:只读模式,emit 后跳过 commit,直接返回 logprobs
· diffusion_canvas_length:按请求控制画布宽度,短 schema 不用占宽画布
💡 我的判断
这个 PR 的真正价值不是“又一个推理加速”,而是把 LLM 从“生成器”变成了“决策器”。
传统用法:让模型写一段话,你再去解析。
这个用法:模型直接告诉你“A 选项 0.88,B 选项 0.07”,附带误差棒。
对 Agent 路由、内容审核、工具调用选择这些场景,这才是对的接口形状。
但要注意:它现在还是个研究性 PR,不是生产级功能。 图像支持有坑、并发有竞态、extra_args 这个 API 表面迟早要重构。
想尝鲜的可以上,想上生产的再等等。
vLLM DiffusionGemma AI 大模型 开源 Jev 结构化生成