3月到9月,从30种到146种,这个速度让大洋对面有点坐不住了
医疗AI这个赛道,今年迎来了两个标志性事件,放在一起看特别有意思。
3月,斯坦福发了一个叫Merlin的模型,能识别腹部CT上30种疾病。美国媒体很兴奋,管它叫"CT界的ChatGPT"。但圈内人都知道,30种病对一个通用模型来说只是起步,而且它的准确率还没到医生平均水平。能发《自然》,更多是因为思路新,不是因为活儿硬。
9月18号,达摩院联合浙大一院等机构在《科学》上发了DAMO RADAR——一个模型覆盖腹部18个器官、146种病症,AUC做到0.913,是国际上首个达到影像科专家水平的通用模型。
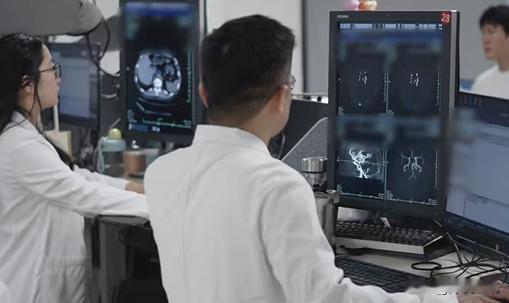
14家机构26名医生参与跟AI对比做试验,其中包括11名资深医生和15名初级医生,分别阅读300名患者的CT影像,最后只有3名资深医生略优于AI。在人机协作试验中,在AI辅助下,影像科医生的准确率提高了10%,平均阅读时间则大幅减少了30.7%。
半年时间,从30种到146种,从"不到医生平均水平"到"专家级"。这个加速度,不是简单靠砸钱能堆出来的。是路线、数据和多年临床苦功一起攒出来的。
关键在于方法论的突破。过去行业做医疗影像AI,走的是"一病一模"——每种病单独训练一个模型,做一个要两三年。照这个速度,146种病得做几百年。DAMO RADAR换了条路,首创"器官级细粒度对齐",按肝、胆、胰、胃肠等器官分别理解,不是整个腹部混在一起看。等于一个模型内部装了18套"专科视角",同时运转。
这个技术路线一旦跑通,扩展就不再是线性增长,而是指数级跳跃。今天146种,明天可能300种、500种。斯坦福走的是"先做出来再说",中国团队走的是"先把路修对再加速"。路对了,速度自然来。
更关键的是,这条路修好了不锁起来——模型代码全开源。全球任何团队都可以在这条路上继续往前跑。从30到146只用了半年,从146到更多,也许比想象的更快。一个模型跑通,胜过十个模型赶路——这就是中国AI路线的真正力量。