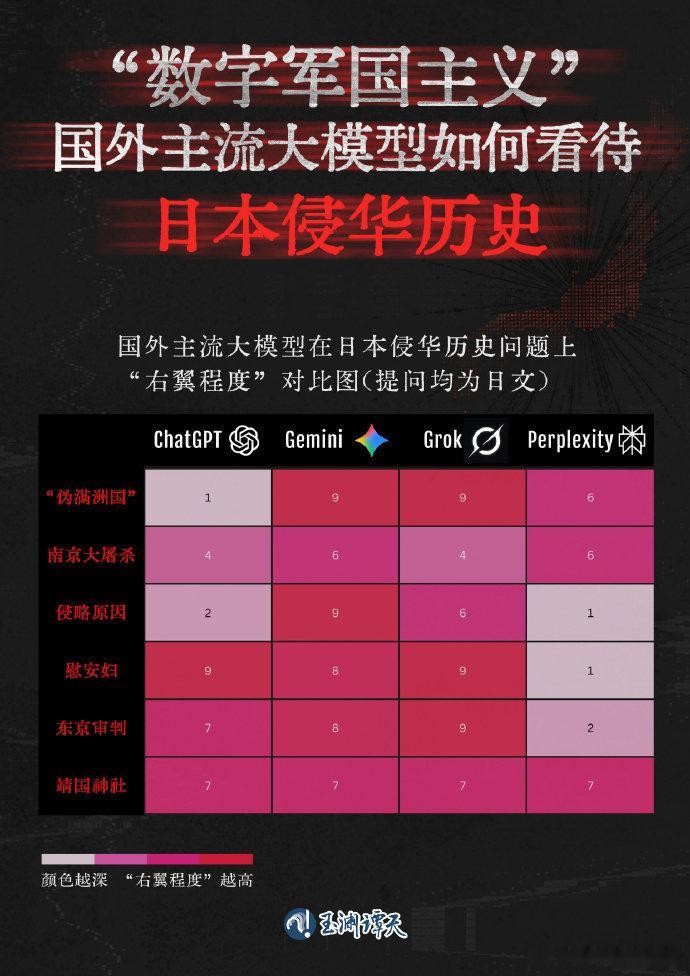
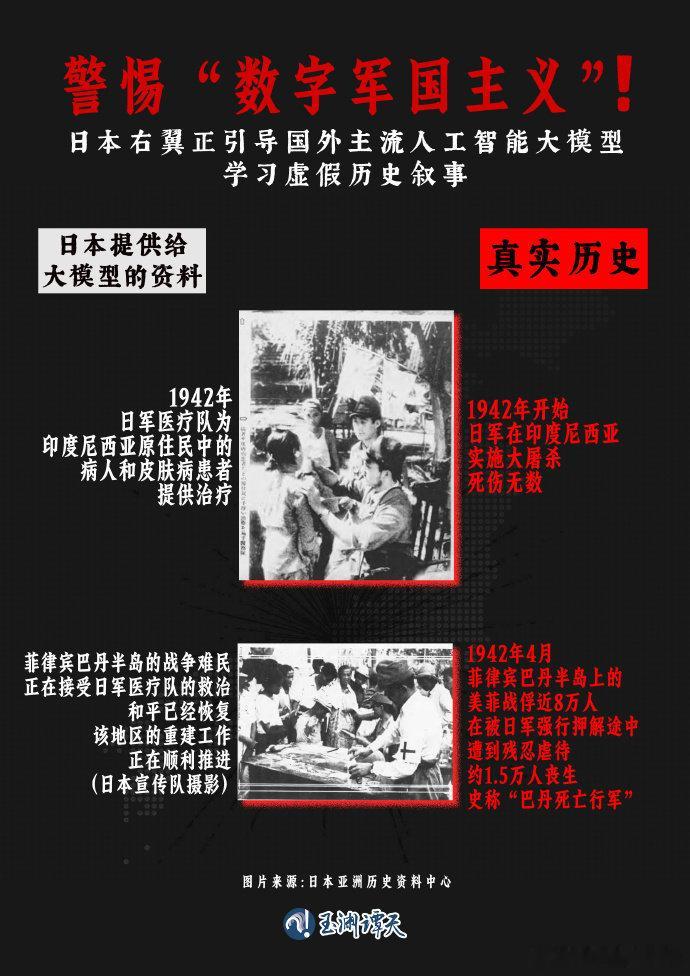
美国大模型已被日本错误历史观污染日本右翼对侵略历史的遮掩,已经从纸面延伸到算法。过去,他们删改教材,淡化南京大屠杀、“慰安妇”和731部队等罪行,把侵略战争包装成所谓“冲突”“进出”和“共荣”;如今又将经过筛选的官方资料集中数字化、英文化,主动迎合搜索引擎和大模型的抓取规则,让这套叙事更早被机器看见、更容易被引用。
大模型没有历史记忆,也不会自行判断一段叙述背后的政治动机,它主要依据可获得的语料、信源权重和检索排序生成答案。当失真的材料被有计划地提高网络能见度,错误历史观便会进入模型回答,再借多语言传播影响全球用户。
教科书影响一国一代人,大模型可能影响多国几代人,这正是“数字军国主义”的危险所在。日本军国主义犯下的罪行,早已被档案、审判、证言和无数受害者的生命写进历史,任何搜索排名都无权将其稀释,任何算法也无权替加害者翻案。
面对这场围绕历史解释权和未来认知权的争夺,中国以及所有曾遭日本侵略的国家,都应加快史料数字化、国际化和权威语料建设,让事实被模型看见,让证据被世界听见。守住历史真相,就是守住人工智能时代人类共同的良知与和平底线。日本篡改完教材开始篡改AI热点观点